
Creatify Agent : un système multi-agents en boucle fermée pour les créations publicitaires vidéo et image
Par Creatify Research · 2026-05-15
Résumé
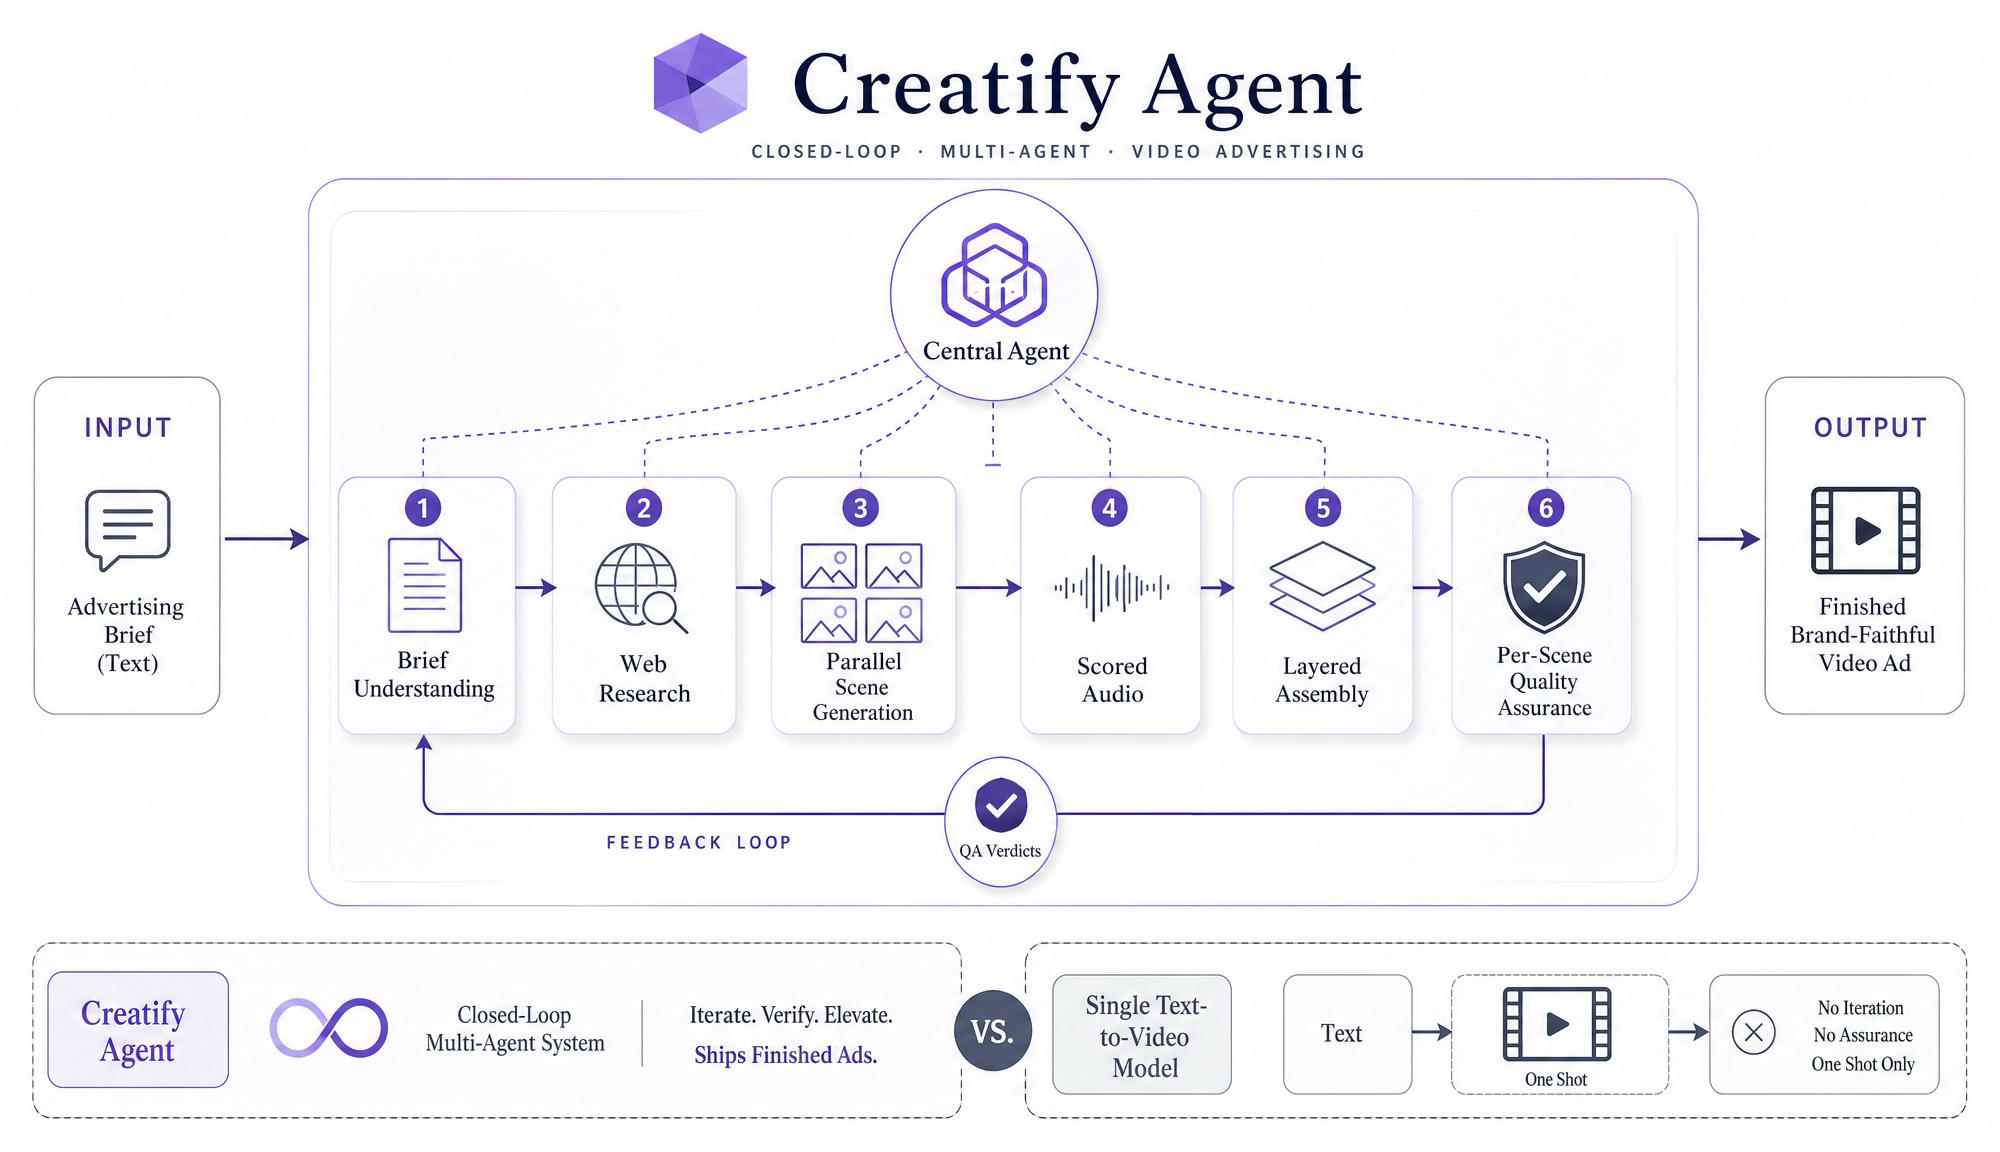
Creatify Agent est un système multi-agents en boucle fermée conçu spécifiquement pour la publicité vidéo et image. À partir d'un seul brief créatif — souvent une simple URL de produit ou une référence de marque —, l'agent planifie le spot, confie chaque scène à un moteur de génération qu'il choisit plan par plan, compose la bande-son, intègre la typographie et vérifie le résultat par rapport au brief avant de livrer une publicité finie et fidèle à la marque. La même architecture en boucle fermée produit des créations image : elle planifie la composition, choisit un moteur de génération pour chaque ressource et vérifie le résultat par rapport au brief. Le système diffère structurellement des deux catégories d'outils voisines auxquelles on le compare le plus souvent : un modèle de fondation text-to-video qui produit un seul clip court à partir d'un prompt, et un agent vidéo généraliste qui encapsule un seul modèle derrière une interface conversationnelle. Ce rapport décrit l'architecture, présente VideoAdAgent Bench v1 — le premier benchmark public pour la production de publicités vidéo par IA — et en livre le résultat principal : Creatify Agent surpasse les agents vidéo généralistes et les modèles text-to-video de pointe sur les indicateurs composites, d'hallucinations et de préférence par paires qui déterminent si une publicité finie est publiable.
0.901
Qualité composite · Creatify Agent Pro
Premier du classement. Le mode Lite suit à 0.836 ; le meilleur système hors Creatify est loin derrière, à 0.585.
95%
Taux de victoire par paires face au text-to-video brut
Part des verdicts consensuels par paires remportés par le mode Pro face aux meilleurs modèles T2V bruts. 87 % face aux agents vidéo généralistes.
1.90
Score d'hallucinations · Creatify Agent Pro
Grille image par image, 0–10 (plus bas = meilleur). Le seul système du panel sous la barre de 2.0 ; les deux variantes de Creatify passent sous le seuil d'ÉCHEC de 3.0 exigé en production (Lite à 2.85).
1 Introduction
Une création publicitaire à la performance — vidéo ou image — diffère structurellement de ce que produit un modèle génératif de pointe. Une publicité vidéo est un livrable multi-plans de 15 à 60 secondes, avec une accroche, des temps forts, un moment produit, une bande-son, une typographie fidèle à la marque et un appel à l'action. Un modèle T2V de fondation — Veo 3.1, Kling 3.0, Seedance 2.0, Sora 2 — rend un seul plan avec une grande fidélité visuelle, sans représentation d'un plan multi-scènes, sans vérification de la cohérence de la marque d'un plan à l'autre, sans bande-son calée sur le rythme du montage et sans couche typographique. Un agent vidéo généraliste encapsule un tel modèle derrière une interface conversationnelle mais hérite des mêmes lacunes : il ajoute une interface de chat, pas la couche de vérification spécialisée dans la publicité qui détermine si une publicité finie est publiable.
Creatify Agent n'appartient à aucune de ces deux catégories. C'est une couche d'orchestration qui prend en entrée une marque et un brief, et répartit le travail entre les modèles de génération, les étapes de recherche, les services audio et les passes de vérification qu'exige le brief. Il choisit les modèles scène par scène au lieu d'en être un. Il maintient un état typé — couleurs de la marque, informations produit, identité des personas, textes obligatoires à l'écran — tout au long de la production, et vérifie chaque scène par rapport à cet état avant la livraison, plutôt que de se fier au premier résultat du générateur. Les travaux récents sur les systèmes d'agents (Mora, VISTA, VideoReward) convergent vers la même conclusion : la décomposition multi-agents avec un critique dans la boucle surpasse la génération par un modèle unique sur toutes les dimensions qui déterminent un livrable fini ; Creatify Agent est une mise en œuvre de cette approche, spécialisée de bout en bout pour la publicité et évaluée face au reste du marché sur le benchmark présenté au §3.
2 Conception du système
Notre agent fonctionne comme une boucle fermée de sous-agents spécialisés. Un producteur intègre le brief, en déduit un plan de scènes et produit un graphe de ressources typé : informations produit, descripteurs de personas, état de la marque, textes obligatoires à l'écran. Des réalisateurs traduisent les spécifications des scènes en appels de génération, en choisissant les modèles et les paramètres plan par plan. Un critique évalue chaque scène rendue par rapport au graphe de ressources selon une grille explicite, puis l'approuve ou la renvoie au réalisateur avec un verdict structuré : une scène qui manque de fidélité est ainsi régénérée localement, sans relancer toute la publicité. La boucle se referme après la livraison : chaque publicité livrée est évaluée, chaque défaut devient un cas de régression et la grille se resserre à chaque production.
2.1 Recherche créative et génération ancrée sur des références
Le producteur peut ancrer un brief dans un contexte créatif réel avant même le rendu de la moindre scène. L'utilisateur peut demander à l'agent de lancer une recherche créative — en interrogeant TikTok et Instagram pour obtenir 8 à 10 publicités performantes dans la catégorie de la marque, avec leurs données d'engagement et l'analyse de leurs accroches —, puis réinjecter les formats obtenus comme référence pour le storyboard : identifier ce qui fonctionne dans la catégorie devient ainsi une étape à part entière que l'utilisateur peut demander, et non un projet de recherche séparé. Deux autres modalités ancrent le brief de la même manière. Une URL (par exemple omakai.com) est récupérée et analysée pour en extraire l'identité de la marque — nom, concept, palette, visuels phares —, si bien qu'un utilisateur sans bibliothèque de ressources importée obtient tout de même un spot fidèle à sa marque. Une vidéo de référence — un TikTok viral, un spot concurrent, une vidéo de marque existante — est décomposée en ses ingrédients clés (rythme des plans, couleurs et lumière, langage de caméra, style de transition, cadence des textes à l'écran), qui servent ensuite de base au plan de scènes. Aucune de ces modalités n'est accessible à un modèle T2V de fondation ou à un agent vidéo généraliste : pour eux, une URL n'est qu'une chaîne de caractères, une vidéo de référence n'est pas prise en charge et le contexte créatif des tendances se situe au-delà de leur date limite d'entraînement.
2.2 Mémoire de marque persistante
L'agent conserve une mémoire structurée d'une session à l'autre, propre à chaque utilisateur et à chaque marque. Les informations produit (prix, caractéristiques phares, éléments à ne pas montrer), la voix et la palette de la marque, les préférences de personas et les orientations créatives qui ont fonctionné sont retenues automatiquement ; une étape de synthèse en fin de session propose les informations durables qui méritent d'être conservées. La deuxième fois qu'un utilisateur demande une publicité pour la même marque, l'agent n'exige ni de réimporter le kit de marque, ni de réexpliquer le prix, ni de rechoisir la voix. Tous les modèles text-to-video et tous les agents vidéo généralistes que nous avons évalués repartent de zéro à chaque appel.
2.3 Skills modulaires et déclinaison en plusieurs formats
Les skills de production sont modulaires. Un même producteur peut livrer un spot UGC porté par un créateur, une démo produit soignée, un témoignage incarné par une persona (basé sur Aurora, le modèle d'avatar maison de Creatify), une vidéo de motion design en typographie animée ou une publicité comparative fondée sur une analyse des concurrents, à partir du même format de brief. Le graphe de ressources structuré permet aussi de décliner un seul brief en plusieurs versions à faible coût marginal — accroches, personas ou formats alternatifs — sans relancer toute la production, puisque chaque axe peut être modifié indépendamment.
2.4 Bande-son
L'audio est généré et synchronisé comme un élément de production à part entière, et non ajouté après coup. Une piste musicale est générée selon le rythme du montage ; la voix off est rendue séparément par une couche TTS avec un ton et un débit adaptés à la marque ; les deux sont intégrées à des décalages connus sur les couches vidéo et typographiques. Toutes les variantes de Creatify du benchmark sont livrées avec une bande-son ; tous les modèles text-to-video bruts sont livrés sans son ; HeyGen V3 n'est livré qu'avec la narration de l'avatar. La qualité audio est l'une des dimensions que les juges du volet 3 (sans brief) notent le plus fortement, ce qui explique en partie la netteté de l'écart observé dans ce volet.
2.5 Contrôle des hallucinations dans la boucle
Le critique est un modèle doté de capacités de vision, exécuté au sein de la boucle de production, et non un filtre a posteriori. Chaque scène est évaluée par rapport au graphe de ressources typé selon une grille explicite — fidélité au produit, hallucination d'objets, qualité du texte, violations physiques, anatomie, qualité globale —, et les échecs sont renvoyés avec un verdict structuré (quelle dimension, dans quelle mesure, sur quelle image) pour être régénérés en intégrant ce retour. La grille et les seuils sont des règles lisibles par un humain, que l'équipe peut resserrer, et non des poids de modèle opaques — un choix de conception formulé dans des travaux récents sur les systèmes d'agents, portant sur le harness comme cible d'optimisation (Lee, Khattab, Finn et al.) et les boucles de critique et de révision fondées sur des règles explicites (Weng). Le critique s'appuie sur une pile de vision maison spécialisée dans les défauts propres à la publicité — dérive du logo, étiquettes produit mal rendues, CTA illisibles, ruptures de continuité entre les plans. Résultat du benchmark : le plus faible score d'hallucinations image par image du panel. Creatify Agent Pro obtient 1.90 (le seul score sous 2.0), Lite 2.85, tous deux sous le seuil d'ÉCHEC de 3.0 exigé en production ; tous les modèles T2V bruts obtiennent 3.65–3.85, et HeyGen V3 4.40.
3 Benchmark
Les benchmarks de qualité vidéo existants (VBench, VBench-2.0, classements par paires de type video arena) mesurent la fidélité image par image des modèles text-to-video bruts ; aucun ne mesure si le résultat fonctionne comme une publicité sur les axes qui déterminent s'il est publiable — force de l'accroche, fidélité à la marque, clarté du CTA, efficacité publicitaire, coût des hallucinations, finition de la production. VideoAdAgent Bench v1 a été conçu pour combler ce manque ; le classement complet, les éléments d'évaluation et les scripts de réexécution sont publics sur la page du benchmark.
3.1 Ensemble de briefs
Le benchmark couvre tous les grands schémas de publicité à la performance — problème-solution, avant-après, démo produit, témoignage, lifestyle —, ainsi que des tests de résistance ciblant les aspects les plus difficiles de la production multi-scènes (storytelling ancré, cohérence des personas, réutilisation des ressources de marque, textes de CTA structurés, respect de l'arc persuasif). Chaque brief est un objet structuré (produit, intention, format, contraintes, ressources d'entrée) utilisant des marques fictives et des maquettes de produits générées par IA, afin d'éviter toute propriété intellectuelle et toute donnée personnelle de vrais clients. L'ensemble complet est pré-enregistré dans un commit tagué avant qu'aucun système ne génère de résultat : aucun système ne peut donc être optimisé pour ces briefs.
3.2 Protocole d'évaluation
Le benchmark distingue trois questions indépendantes, réparties en trois volets d'évaluation par paires distincts. Chaque duel est évalué par deux juges LLM dotés de capacités de vision (Claude Opus 4.7 + GPT-5), deux fois avec inversion des positions pour neutraliser le biais gauche-droite ; un verdict ne compte que si le juge reste cohérent après l'inversion, et les deux juges doivent être d'accord pour obtenir un verdict consensuel.
| Volet | Question | Duels | Indicateur principal |
|---|---|---|---|
| Volet 1 — Capacité | L'agent est-il meilleur que les autres systèmes vidéo agentiques ? | Creatify face à chaque agent vidéo généraliste (HeyGen V3, Luma). Les juges voient le brief. | Taux de victoire face aux agents concurrents. |
| Volet 2 — Qualité publicitaire | L'agent est-il meilleur que les meilleurs modèles T2V bruts ? | Creatify face à Veo 3.1, Kling 3.0 et Seedance 2.0. Deux configurations de référence par modèle : scène unique (appel API par défaut — un prompt, un clip de 8–12 s) et multi-scènes (prompts planifiés par scène, puis assemblés). Les juges voient le brief et notent huit dimensions de qualité publicitaire ; le tableau principal présente la configuration multi-scènes. | Préférence globale (0–1). |
| Volet 3 — Qualité de production vidéo | Le résultat est-il un livrable de meilleure qualité, indépendamment du brief ? | Mêmes duels qu'au volet 2, mais les juges ne voient pas le brief. Une grille d'hallucinations image par image est intégrée avec une pondération 3× par rapport à la conformité structurelle. | Score de qualité vidéo (0–1). |
Le score composite du classement combine le volet 2 (qualité publicitaire) et le volet 3 (qualité de production) : un système doit donc performer sur les deux axes pour progresser. Un score d'hallucinations image par image (0–10, plus bas = meilleur ; ≥ 3.0 correspond à un ÉCHEC en production) est intégré au volet 3 et publié dans une colonne distincte du classement.
4 Résultats
Le score composite place Creatify Agent en tête du classement ; ses deux variantes en production devancent tous les agents vidéo généralistes et tous les modèles T2V bruts sur chaque indicateur agrégé. Tous les systèmes — Creatify comme chacun de ses concurrents — sont évalués en conditions one-shot : un seul brief en entrée, une seule publicité en sortie, sans tour de retour. En production, Creatify Agent est conversationnel et permet des révisions précises scène par scène ; le benchmark retire délibérément cette capacité pour garantir une comparaison équitable avec les modèles en un seul passage, ce qui signifie que l'expérience en production dépasse les chiffres présentés ici.
| Rang | Système | Composite | Volet 1 | Volet 2 | Volet 3 | Hallucinations ↓ |
|---|---|---|---|---|---|---|
| 1 | Creatify Agent · Pro | 0.901 | 0.732 | 0.775 | 0.855 | 1.90 |
| 2 | Creatify Agent · Lite | 0.836 | 0.716 | 0.757 | 0.778 | 2.85 |
| 3 | Luma Agent | 0.585 | 0.580 | 0.603 | 0.741 | 3.20 |
| 4 | HeyGen V3 Agent | 0.327 | 0.358 | 0.378 | 0.609 | 4.40 |
| 5 | Seedance 2.0 (multi-scènes) | 0.312 | — | 0.337 | 0.588 | 3.65 |
| 6 | Kling 3.0 (multi-scènes) | 0.301 | — | 0.365 | 0.585 | 3.80 |
| 7 | Veo 3.1 (multi-scènes) | 0.287 | — | 0.362 | 0.549 | 3.85 |
5 Études de cas
Trois résultats réels issus de l'application en production, générés à partir du même prompt et comparés aux meilleures alternatives commerciales (un modèle T2V de fondation, un agent vidéo généraliste). Aucune sélection pour ce rapport. Chaque cas met en évidence une capacité différente de l'agent — décomposition du brief, ancrage sur les ressources de marque, recherche web — sans équivalent en un seul passage.
5.1 Publicité culinaire multi-plans
Publicité culinaire TikTok de 20 secondes, ~50 plans d'environ 0.4 s chacun. Comparée à Veo 3.1 (T2V en un seul passage) et HeyGen V3 (agent vidéo généraliste).
Prompt« crée une vidéo culinaire multi-plans ultra rythmée, plans de 0.4 seconde, où l'on prépare des pâtes au poulet et au pesto. la vidéo complète dure 20 secondes »
Le producteur interprète le prompt comme une liste de plans, le décompose en ~50 plans confiés en parallèle à des réalisateurs dédiés, puis cale la bande-son sur le rythme du montage. L'API de Veo 3.1 n'a aucun paramètre pour la durée totale ni pour une structure multi-plans (durée maximale de 8 s par appel, une seule prise en sortie). HeyGen V3 interprète le prompt comme le texte de narration de son avatar plutôt que comme une spécification de plans.
5.2 Publicité Instagram ancrée sur une image de marque
L'utilisateur importe une image de référence de la marque TopStep et demande une publicité Instagram montrant un randonneur atteignant un sommet. Comparée à Veo 3.1 en image-to-video (l'image de marque servant d'image de départ) et à HeyGen V3 (prompt uniquement — pas d'image en entrée).
Prompt« Crée une série de publicités Instagram en carrousel pour TopStep @input:image-1 en utilisant l'image de référence et en y insérant un randonneur qui gravit la montagne avec pour objectif d'atteindre le sommet »
L'image de référence est intégrée au graphe de ressources typé et ancre chaque scène : les couleurs de la marque sont conservées, le logo est rendu comme une couche typographique vérifiée sur le carton de fin, et le personnage du randonneur reste cohérent tout au long de l'arc mise en place→effort→sommet. Veo 3.1 conserve l'image de départ dans une seule prise de 8 secondes, mais n'a aucune représentation d'un arc multi-scènes. L'API de HeyGen V3 n'accepte qu'un prompt texte : l'image de marque n'est donc pas utilisée.
5.3 Brief limité à une URL, sans ressources importées
L'utilisateur colle une URL ; l'agent récupère le site, en extrait l'identité de la marque et rédige son propre brief. Aucun des modèles de référence ne peut accéder au web.
Prompt« Crée une publicité vidéo TikTok verticale pour https://omakai.com/ »
OMAKAI est un restaurant de sushis omakase à Miami. L'étape de recherche web du producteur récupère omakai.com, en extrait le nom de la marque, le concept omakase et le positionnement à Miami, puis ancre le storyboard avant tout appel de génération. Aucun des modèles de référence ne dispose de recherche web : Veo 3.1 produit à partir du prompt des images de restaurant visuellement correctes mais génériques ; HeyGen V3 fait lire l'URL elle-même en voix off. Les briefs limités à une URL constituent le cas d'onboarding PME le plus fréquent dans l'application en production.
6 Limites
Peu d'hallucinations, mais pas zéro. Les deux variantes de Creatify passent sous le seuil d'hallucinations exigé en production (Pro à 1.90, Lite à 2.85), mais une petite part des publicités générées en mode Pro présente encore un léger flottement du texte de marque ou une incohérence subtile entre les plans que le critique n'a pas détectée. Ramener ce résidu vers zéro est un axe de recherche actif.
Évaluation one-shot uniquement. Le benchmark évalue un seul brief en entrée et une seule publicité en sortie, sans tour de retour. L'agent en production est conversationnel : un utilisateur qui signale un défaut résiduel (« le prix dans la scène 3 est faux ») déclenche une régénération ciblée de la scène, avec la correction intégrée. Le taux d'hallucinations atteignable grâce aux retours interactifs est nettement inférieur au chiffre one-shot présenté ici et n'est pas étudié dans ce rapport.
7 Reproductibilité
Chaque affirmation de ce rapport peut être reproduite à partir du benchmark public, publié en open source en même temps que ce lancement sur github.com/creatify-ai/VABench. L'ensemble des briefs, les schémas, les prompts des juges, les grilles de notation, les structures d'exécution et les scripts d'agrégation sont tous inclus. L'ensemble des briefs a été pré-enregistré dans un commit tagué avant qu'aucun système ne génère de résultat : aucun système du benchmark n'a donc pu être optimisé pour ces briefs.
8 Travaux connexes
- Génération vidéo multi-agents : Mora, VideoDirectorGPT, FilmAgent, StoryAgent, VISTA.
- Benchmarks de qualité vidéo : VBench / VBench-2.0 ; VideoGen-Eval ; Artificial Analysis Video Arena pour le contrôle du biais de position dans les comparaisons par paires.
- Modélisation de la récompense pour la vidéo : VideoReward / Flow-DPO, UnifiedReward.
- Grilles spécifiques à la publicité : Springboards Creativity Benchmark, AdsQA, le Pitt Ads Dataset, « Decoding the Hook » pour l'évaluation des 3 premières secondes.
- Assurance qualité en boucle fermée : Meta-Harness (Lee, Khattab, Finn et al.) ; Learning Beyond Gradients (Weng) sur les boucles de critique et de révision appliquées à des politiques explicites.