Creatify Agent: un sistema multiagente de ciclo cerrado para creatividades publicitarias en vídeo e imagen
Por Creatify Research · 2026-05-15
Resumen
Creatify Agent es un sistema multiagente de ciclo cerrado diseñado específicamente para publicidad en vídeo e imagen. A partir de un único brief creativo — a menudo solo la URL de un producto o una referencia de marca —, el agente planifica el spot, envía cada escena a un motor de generación que elige para cada toma, compone el audio, integra la tipografía y verifica el resultado frente al brief antes de entregar un anuncio terminado y fiel a la marca. La misma arquitectura de ciclo cerrado produce creatividades de imagen: planifica la composición, elige un motor de generación para cada recurso y verifica el resultado frente al brief. El sistema es estructuralmente distinto de las dos clases de herramientas con las que más se compara: un modelo fundacional de texto a vídeo que produce un único clip corto a partir de un prompt, y un agente de vídeo de uso general que envuelve un único modelo tras una interfaz conversacional. Este informe describe la arquitectura, presenta VideoAdAgent Bench v1 — el primer benchmark público para la producción de anuncios en vídeo con IA — y expone el resultado principal: Creatify Agent supera a los agentes de vídeo de uso general y a los modelos de texto a vídeo de vanguardia en las métricas compuesta, de alucinaciones y de preferencia por pares que determinan si un anuncio terminado se puede publicar.
0.901
Calidad compuesta · Creatify Agent Pro
Primero del sector. El modo Lite le sigue con 0.836; el sistema ajeno a Creatify más fuerte se queda en 0.585.
95%
Tasa de victorias por pares frente a texto a vídeo sin procesar
Proporción de veredictos de consenso por pares que gana el modo Pro frente a los modelos T2V sin procesar más fuertes. 87% frente a agentes de vídeo de uso general.
1.90
Puntuación de alucinaciones · Creatify Agent Pro
Rúbrica por fotograma, 0–10 (menor es mejor). El único sistema del sector por debajo de 2.0; ambas variantes de Creatify superan el umbral de FALLO de calidad de producción de 3.0 (Lite con 2.85).
1 Introducción
Una creatividad publicitaria de rendimiento — en vídeo o imagen — es estructuralmente distinta del resultado que produce un modelo generativo de vanguardia. Un anuncio en vídeo es un entregable de varias tomas de 15 a 60 segundos con un gancho, momentos de desarrollo, un momento de producto, audio compuesto, tipografía acorde a la marca y una llamada a la acción. Un modelo T2V fundacional — Veo 3.1, Kling 3.0, Seedance 2.0, Sora 2 — renderiza una sola toma con gran fidelidad visual, sin representación de un plan multiescena, sin verificación del estado de la marca entre cortes, sin audio ajustado al ritmo de los cortes y sin capa tipográfica. Un agente de vídeo de uso general envuelve un modelo así tras una interfaz conversacional, pero hereda la misma carencia: añade una superficie de chat, no la capa de verificación especializada en anuncios que determina si un anuncio terminado se puede publicar.
Creatify Agent no pertenece a ninguna de esas dos clases. Es una capa de orquestación que recibe una marca y un brief como entrada y distribuye el trabajo entre los modelos de generación, pasos de búsqueda, servicios de audio y pasadas de verificación que requiera el brief. Selecciona modelos para cada escena en lugar de ser uno. Mantiene un estado tipado — colores de marca, datos del producto, identidad del personaje, texto obligatorio en pantalla — a lo largo de la producción y verifica cada escena frente a ese estado antes de la entrega, en lugar de fiarse del primer resultado del generador. La investigación reciente en sistemas de agentes (Mora, VISTA, VideoReward) ha llegado a la conclusión de que la descomposición multiagente con un crítico dentro del ciclo supera a la generación con un único modelo en todas las dimensiones que determinan un entregable terminado; Creatify Agent es una materialización de esa dirección, especializada de principio a fin en publicidad y evaluada frente al resto del sector en el benchmark presentado en el §3.
2 Diseño del sistema
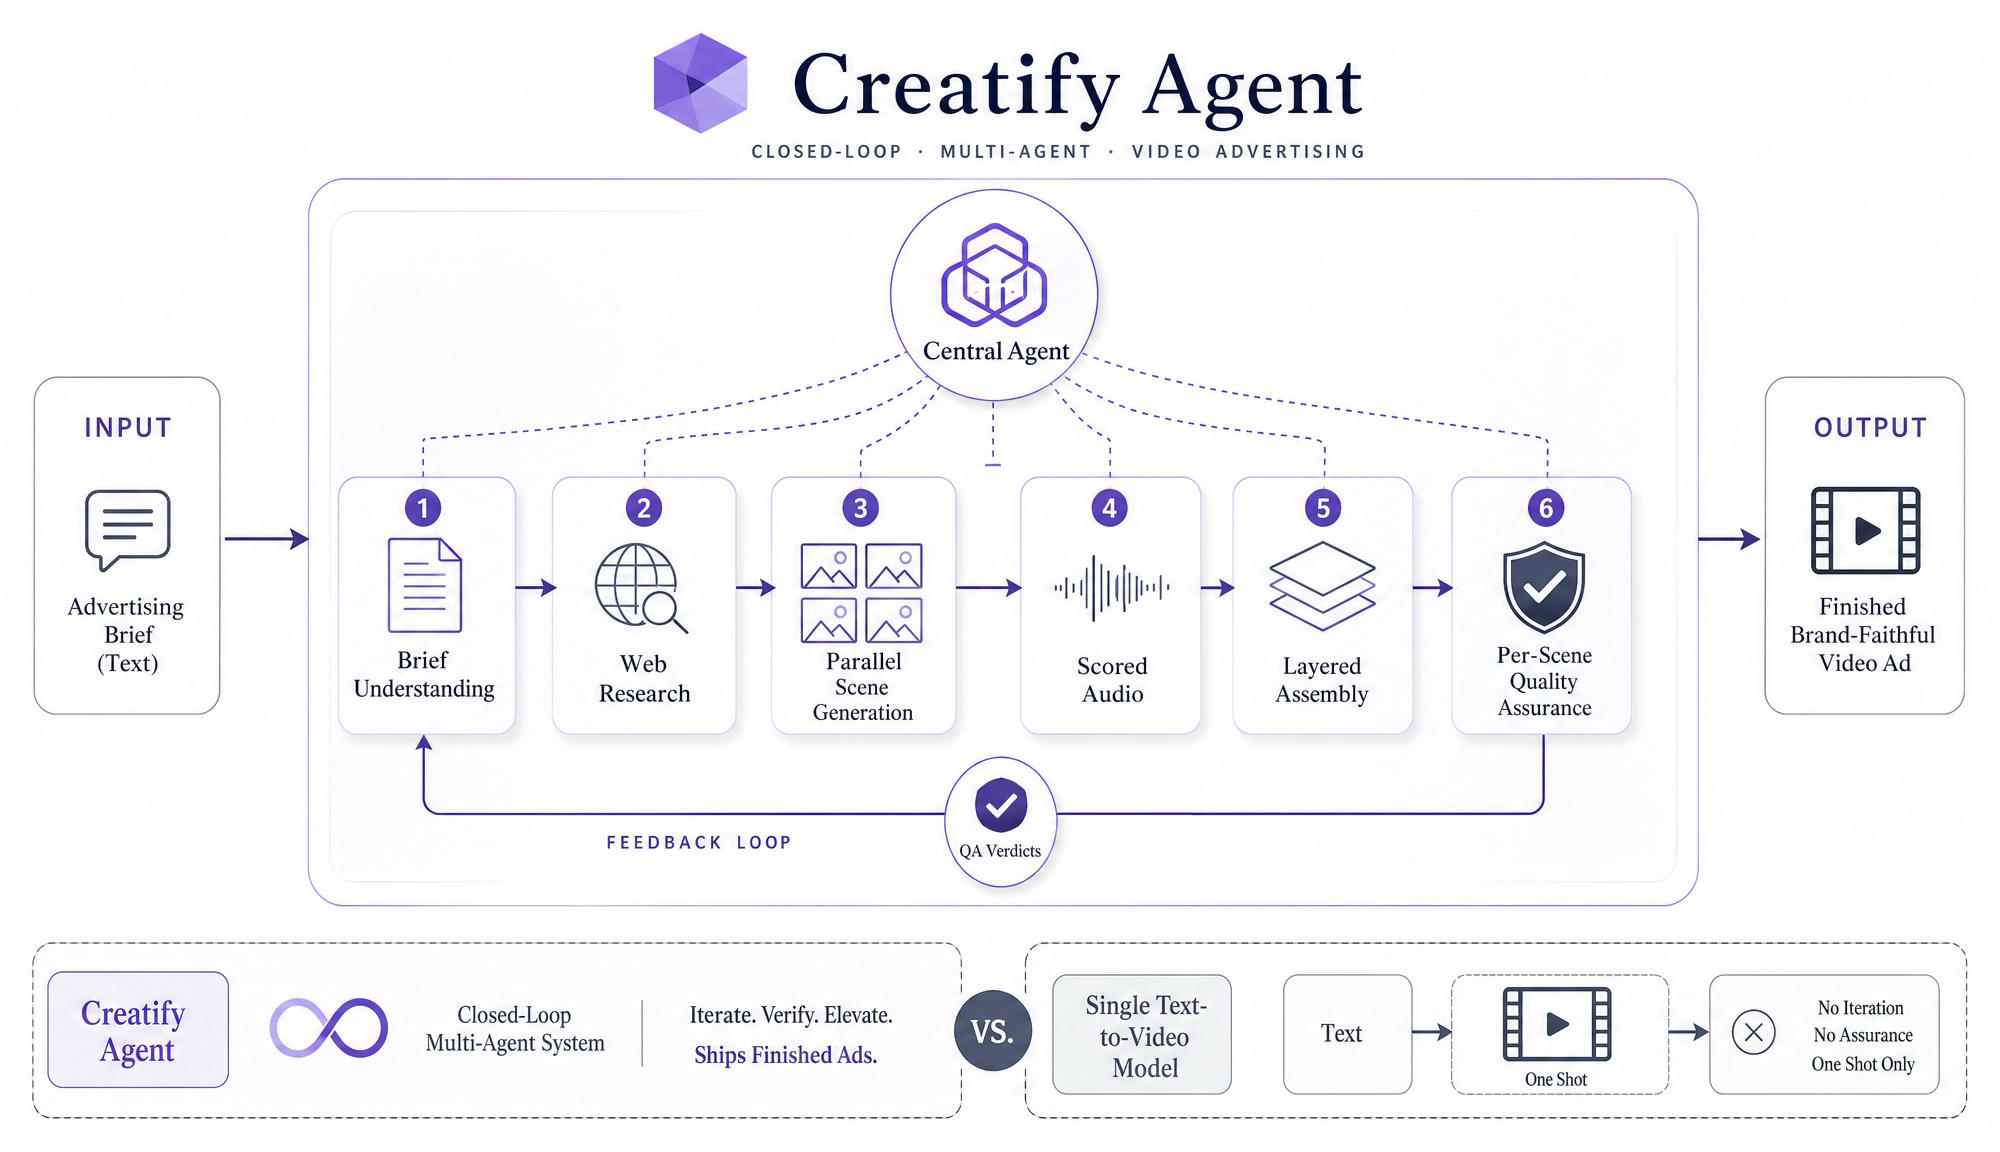
Nuestro agente funciona como un ciclo cerrado de subagentes especializados. Un productor recibe el brief, elabora un plan de escenas y genera un grafo de recursos tipado: datos del producto, descriptores del personaje, estado de la marca y texto obligatorio en pantalla. Los directores traducen las especificaciones de cada escena en llamadas de generación, eligiendo modelos y parámetros para cada toma. Un crítico evalúa cada escena renderizada frente al grafo de recursos según una rúbrica explícita y la aprueba o la devuelve al director con un veredicto estructurado, de modo que una escena que falla en fidelidad se regenera localmente en lugar de obligar a rehacer todo el anuncio. El ciclo se cierra tras la entrega: cada anuncio publicado se evalúa, cada defecto se convierte en un caso de regresión y la rúbrica se vuelve más exigente con cada producción.
2.1 Investigación creativa y generación anclada en referencias
El productor puede basar un brief en un contexto creativo real antes de renderizar ninguna escena. El usuario puede pedir al agente que realice una búsqueda creativa — consultando TikTok e Instagram para obtener 8–10 anuncios de alto rendimiento en la categoría de la marca, con metadatos de interacción y desglose del gancho — y luego usar esos formatos como referencia para el storyboard, de modo que identificar qué funciona en la categoría se convierte en un paso de primer nivel que el usuario puede solicitar, en lugar de un proyecto de investigación aparte. Otras dos modalidades fundamentan el brief del mismo modo. Una URL (por ejemplo omakai.com) se descarga y analiza para extraer la identidad de marca — nombre, concepto, paleta, imágenes principales —, así que un usuario sin biblioteca de recursos subida también obtiene un spot fiel a la marca. Un vídeo de referencia — un TikTok viral, un spot de la competencia, un reel de marca existente — se descompone en sus ingredientes clave (ritmo de las tomas, color e iluminación, lenguaje de cámara, estilo de transición, cadencia del texto en pantalla), que luego fundamentan el plan de escenas. Ninguna de estas modalidades está disponible para un modelo T2V fundacional ni para un agente de vídeo de uso general: para ellos una URL es una cadena de caracteres, un vídeo de referencia no es compatible y el contexto creativo en tendencia queda fuera de su fecha de corte de entrenamiento.
2.2 Memoria de marca persistente
El agente mantiene una memoria estructurada entre sesiones, organizada por usuario y por marca. Los datos del producto (precios, características principales, elementos que no deben mostrarse), la voz y la paleta de colores de la marca, las preferencias de personaje y las direcciones creativas que han funcionado se conservan automáticamente; un paso de destilación al final de cada sesión propone los datos duraderos que merece la pena guardar. La segunda vez que un usuario pide un anuncio para la misma marca, el agente no necesita que vuelva a subir el kit de marca, a explicar el precio ni a elegir la voz. Todos los modelos de texto a vídeo y todos los agentes de vídeo de uso general que evaluamos empiezan de cero en cada llamada.
2.3 Habilidades modulares y expansión a múltiples resultados
Las habilidades de producción son modulares. Un mismo productor puede entregar un spot UGC protagonizado por un creador, una demostración de producto pulida, un testimonio con personaje (basado en Aurora, el modelo de avatares propio de Creatify), un reel de motion design con tipografía cinética o un anuncio comparativo basado en investigación de la competencia, a partir del mismo formato de brief. El grafo de recursos estructurado también permite expandir un único brief a múltiples resultados con un coste marginal bajo — ganchos alternativos, personajes alternativos, relaciones de aspecto alternativas — sin rehacer toda la producción, ya que cada eje puede modificarse de forma independiente.
2.4 Composición del audio
El audio se genera y sincroniza como un elemento de producción de primer nivel, no se añade al final como algo secundario. Se genera una pista musical ajustada al ritmo de los cortes; la locución se renderiza por separado con una capa de TTS con el tono y el ritmo adecuados para la marca; ambas se integran con desfases conocidos sobre las capas de vídeo y tipografía. Todas las variantes de Creatify del benchmark incluyen audio compuesto; todos los modelos de texto a vídeo sin procesar se entregan sin sonido; HeyGen V3 solo incluye la narración del avatar. La calidad del audio es una de las dimensiones que los jueces del eje 3 (sin brief) puntúan con más fuerza, lo que explica en parte la clara separación en el eje 3.
2.5 Control de alucinaciones dentro del ciclo
El crítico es un modelo con capacidad de visión que se ejecuta dentro del ciclo de producción, no un filtro posterior. Cada escena se evalúa frente al grafo de recursos tipado según una rúbrica explícita — fidelidad del producto, alucinación de objetos, calidad del texto, infracciones físicas, anatomía, calidad general — y los fallos se devuelven con un veredicto estructurado (qué dimensión, en qué medida, en qué fotograma) para regenerarlos con esa información incorporada. La rúbrica y los umbrales son reglas legibles que el equipo puede endurecer, no pesos de modelo opacos — una decisión de diseño expuesta en trabajos recientes sobre sistemas de agentes, como el arnés como objetivo de optimización (Lee, Khattab, Finn et al.) y los ciclos de crítica y revisión sobre políticas explícitas (Weng). El crítico funciona sobre una pila de visión propia especializada en los fallos típicos de los anuncios — deriva del logotipo, etiquetas de producto mal renderizadas, CTA ilegibles, rupturas de continuidad entre cortes. El resultado del benchmark es la puntuación de alucinaciones por fotograma más baja del sector: Creatify Agent Pro con 1.90 (la única por debajo de 2.0) y Lite con 2.85, ambos por debajo del umbral de FALLO de calidad de producción de 3.0; todos los modelos T2V sin procesar obtienen 3.65–3.85 y HeyGen V3, 4.40.
3 Benchmark
Los benchmarks de calidad de vídeo existentes (VBench, VBench-2.0, clasificaciones por pares tipo video-arena) miden la fidelidad por fotograma de modelos de texto a vídeo sin procesar; ninguno mide si el resultado funciona como anuncio en los aspectos que determinan si se puede publicar — fuerza del gancho, fidelidad a la marca, claridad del CTA, eficacia publicitaria, coste de las alucinaciones, acabado de producción. VideoAdAgent Bench v1 se creó para llenar ese vacío; la clasificación completa, los materiales de evaluación y los scripts para repetirla son públicos en la página del benchmark.
3.1 Conjunto de briefs
El benchmark cubre todos los patrones principales de anuncios de rendimiento — problema-solución, antes-después, demostración de producto, testimonio, estilo de vida — además de pruebas de estrés dirigidas a los aspectos más difíciles de la producción multiescena (narrativa con hilo conductor, coherencia del personaje, reutilización de recursos de marca, texto de CTA estructurado, cumplimiento del arco persuasivo). Cada brief es un objeto estructurado (producto, intención, formato, restricciones, recursos de entrada) que usa marcas ficticias y maquetas de producto generadas con IA para evitar la propiedad intelectual y los datos personales de clientes reales. El conjunto completo se prerregistra en un commit etiquetado antes de que ningún sistema genere resultados, de modo que ningún sistema pueda ajustarse a los briefs concretos.
3.2 Protocolo de evaluación
El benchmark separa tres preguntas independientes en tres ejes de evaluación por pares. Cada par lo evalúan dos jueces LLM con capacidad de visión (Claude Opus 4.7 + GPT-5) dos veces, intercambiando las posiciones para controlar el sesgo izquierda-derecha; un veredicto solo cuenta cuando el juez coincide consigo mismo tras el intercambio, y ambos jueces deben coincidir para que haya un veredicto de consenso.
| Eje | Pregunta | Pares | Métrica principal |
|---|---|---|---|
| Eje 1 — Capacidad | ¿Es el agente mejor que otros sistemas de vídeo agénticos? | Creatify frente a todos los agentes de vídeo de uso general (HeyGen V3, Luma). Los jueces ven el brief. | Tasa de victorias frente al resto de agentes. |
| Eje 2 — Calidad del anuncio | ¿Es el agente mejor que los modelos T2V sin procesar más potentes? | Creatify frente a Veo 3.1, Kling 3.0 y Seedance 2.0. Dos configuraciones de referencia por modelo: una escena (llamada a la API por defecto — un prompt, un clip de 8–12 s) y multiescena (prompts planificados por escena, unidos). Los jueces ven el brief y puntúan ocho dimensiones de calidad publicitaria; la tabla principal muestra la configuración multiescena. | Preferencia general (0–1). |
| Eje 3 — Calidad de producción del vídeo | ¿Es el resultado un entregable de mayor calidad, sin tener en cuenta el brief? | Los mismos pares que en el eje 2, pero los jueces no ven el brief. Se incorpora una rúbrica de alucinaciones por fotograma con un peso 3× frente al cumplimiento estructural. | Puntuación de calidad de vídeo (0–1). |
La puntuación compuesta de la clasificación combina el eje 2 (calidad del anuncio) y el eje 3 (calidad de producción), por lo que un sistema debe rendir en ambos para escalar posiciones. Una puntuación de alucinaciones por fotograma (0–10, menor es mejor; ≥ 3.0 es un FALLO de calidad de producción) se incorpora al eje 3 y se publica como columna aparte en la clasificación.
4 Resultados
La puntuación compuesta sitúa a Creatify Agent en primer lugar; ambas variantes en producción superan a todos los agentes de vídeo de uso general y a todos los modelos T2V sin procesar en todas las métricas agregadas. Todos los sistemas — Creatify y cada competidor — se evalúan en condiciones de un solo intento: un brief de entrada, un anuncio de salida, sin turno de feedback. La versión en producción de Creatify Agent es conversacional y admite revisiones precisas por escena; el benchmark elimina deliberadamente esa capacidad para que la comparación sea justa frente a modelos de un solo intento, lo que significa que la experiencia real supera las cifras que aquí se presentan.
| Posición | Sistema | Compuesta | Eje 1 | Eje 2 | Eje 3 | Alucinaciones ↓ |
|---|---|---|---|---|---|---|
| 1 | Creatify Agent · Pro | 0.901 | 0.732 | 0.775 | 0.855 | 1.90 |
| 2 | Creatify Agent · Lite | 0.836 | 0.716 | 0.757 | 0.778 | 2.85 |
| 3 | Luma Agent | 0.585 | 0.580 | 0.603 | 0.741 | 3.20 |
| 4 | HeyGen V3 Agent | 0.327 | 0.358 | 0.378 | 0.609 | 4.40 |
| 5 | Seedance 2.0 (multiescena) | 0.312 | — | 0.337 | 0.588 | 3.65 |
| 6 | Kling 3.0 (multiescena) | 0.301 | — | 0.365 | 0.585 | 3.80 |
| 7 | Veo 3.1 (multiescena) | 0.287 | — | 0.362 | 0.549 | 3.85 |
5 Casos de estudio
Tres resultados reales de la aplicación en producción, generados con el mismo prompt frente a las alternativas comerciales más potentes (un modelo T2V fundacional y un agente de vídeo de uso general). Sin selección previa para el informe. Cada caso muestra una capacidad distinta del agente — descomposición del brief, anclaje en recursos de marca, investigación web — sin equivalente en un solo intento.
5.1 Anuncio de cocina con varias tomas
Anuncio de cocina para TikTok de 20 segundos, ~50 cortes de ~0.4 s cada uno. Comparado con Veo 3.1 (T2V de una toma) y HeyGen V3 (agente de vídeo de uso general).
Prompt"make a super fast paced, .4 second multi shot cooking video making chicken pesto pasta. full video is 20 seconds"
El productor interpreta el prompt como una lista de tomas, lo descompone en ~50 cortes que envía en paralelo a directores por escena y compone el audio al ritmo de los cortes. La API de Veo 3.1 no tiene ningún parámetro para la duración total ni para una estructura de varias tomas (duración máxima por llamada de 8 s, una sola toma como resultado). HeyGen V3 interpreta el prompt como el contenido de la narración de su avatar, no como una especificación de tomas.
5.2 Anuncio de Instagram anclado en una imagen de marca
El usuario sube una imagen de referencia de la marca TopStep y pide un anuncio de Instagram de un excursionista llegando a la cima. Comparado con Veo 3.1 de imagen a vídeo (la imagen de marca como fotograma inicial) y HeyGen V3 (solo prompt, sin entrada de imagen).
Prompt"Create an Instagram carousel ad set for TopStep @input:image-1 using the reference image and inserting a hiker making his way up to mountain with the goal of getting to the top of the mountain"
La imagen de referencia se incorpora al grafo de recursos tipado y ancla todas las escenas: los colores de la marca se mantienen, el logotipo se renderiza como una capa tipográfica verificada en el cierre final y el excursionista se mantiene a lo largo del arco planteamiento→esfuerzo→cima. Veo 3.1 conserva el fotograma inicial dentro de una toma de 8 segundos, pero no tiene representación de un arco multiescena. La API de HeyGen V3 solo acepta un texto como prompt, por lo que no usa la imagen de marca.
5.3 Brief con solo una URL, sin recursos subidos
El usuario pega una URL; el agente accede al sitio, extrae la identidad de marca y redacta su propio brief. Ninguno de los sistemas de referencia puede acceder a la web.
Prompt"Create a vertical TikTok video ad for https://omakai.com/"
OMAKAI es un restaurante de sushi omakase en Miami. El paso de búsqueda web del productor accede a omakai.com, extrae el nombre de la marca, el concepto omakase y su posicionamiento en Miami, y fundamenta el storyboard antes de cualquier llamada de generación. Ninguno de los sistemas de referencia tiene búsqueda web: Veo 3.1 produce imágenes de restaurante visualmente correctas pero genéricas a partir del texto del prompt; HeyGen V3 lee la propia URL como locución. Los briefs con solo una URL son el caso más habitual de incorporación de pymes en la aplicación.
6 Limitaciones
Las alucinaciones son bajas, pero no nulas. Ambas variantes de Creatify superan el umbral de alucinaciones de calidad de producción (Pro con 1.90, Lite con 2.85), pero una pequeña parte de los anuncios generados con Pro aún contiene una leve variación en el texto de la marca o una sutil incoherencia entre cortes que el crítico no detectó. Reducir ese residuo a cero es una línea de investigación activa.
Solo evaluación de un intento. El benchmark evalúa un brief de entrada y un anuncio de salida, sin turno de feedback. El agente en producción es conversacional; si un usuario señala un defecto residual ("el precio de la escena 3 está mal"), se activa una regeneración precisa de esa escena con la corrección incorporada. La tasa de alucinaciones que se puede lograr con feedback interactivo es sensiblemente menor que la cifra de un solo intento que aquí se presenta, y no se estudia en este informe.
7 Reproducibilidad
Todas las afirmaciones de este informe pueden reproducirse a partir del benchmark público, publicado como código abierto junto con este lanzamiento en github.com/creatify-ai/VABench. Incluye el conjunto de briefs, los esquemas, los prompts de los jueces, las rúbricas de puntuación, la estructura de ejecución y los scripts de agregación. El conjunto de briefs se prerregistró en un commit etiquetado antes de que ningún sistema generara resultados, de modo que ningún sistema del benchmark pudo ajustarse a los briefs concretos.
8 Trabajos relacionados
- Generación de vídeo multiagente: Mora, VideoDirectorGPT, FilmAgent, StoryAgent, VISTA.
- Benchmarks de calidad de vídeo: VBench / VBench-2.0; VideoGen-Eval; Artificial Analysis Video Arena para el control del sesgo de posición en comparaciones por pares.
- Modelado de recompensas para vídeo: VideoReward / Flow-DPO, UnifiedReward.
- Rúbricas específicas de publicidad: Springboards Creativity Benchmark, AdsQA, el Pitt Ads Dataset, "Decoding the Hook" para la evaluación de los 3 primeros segundos.
- Control de calidad de ciclo cerrado: Meta-Harness (Lee, Khattab, Finn et al.); Learning Beyond Gradients (Weng), sobre ciclos de crítica y revisión con políticas explícitas.