Creatify Agent:面向视频与图片广告创意的闭环多智能体系统
Creatify Research · 2026-05-15
摘要
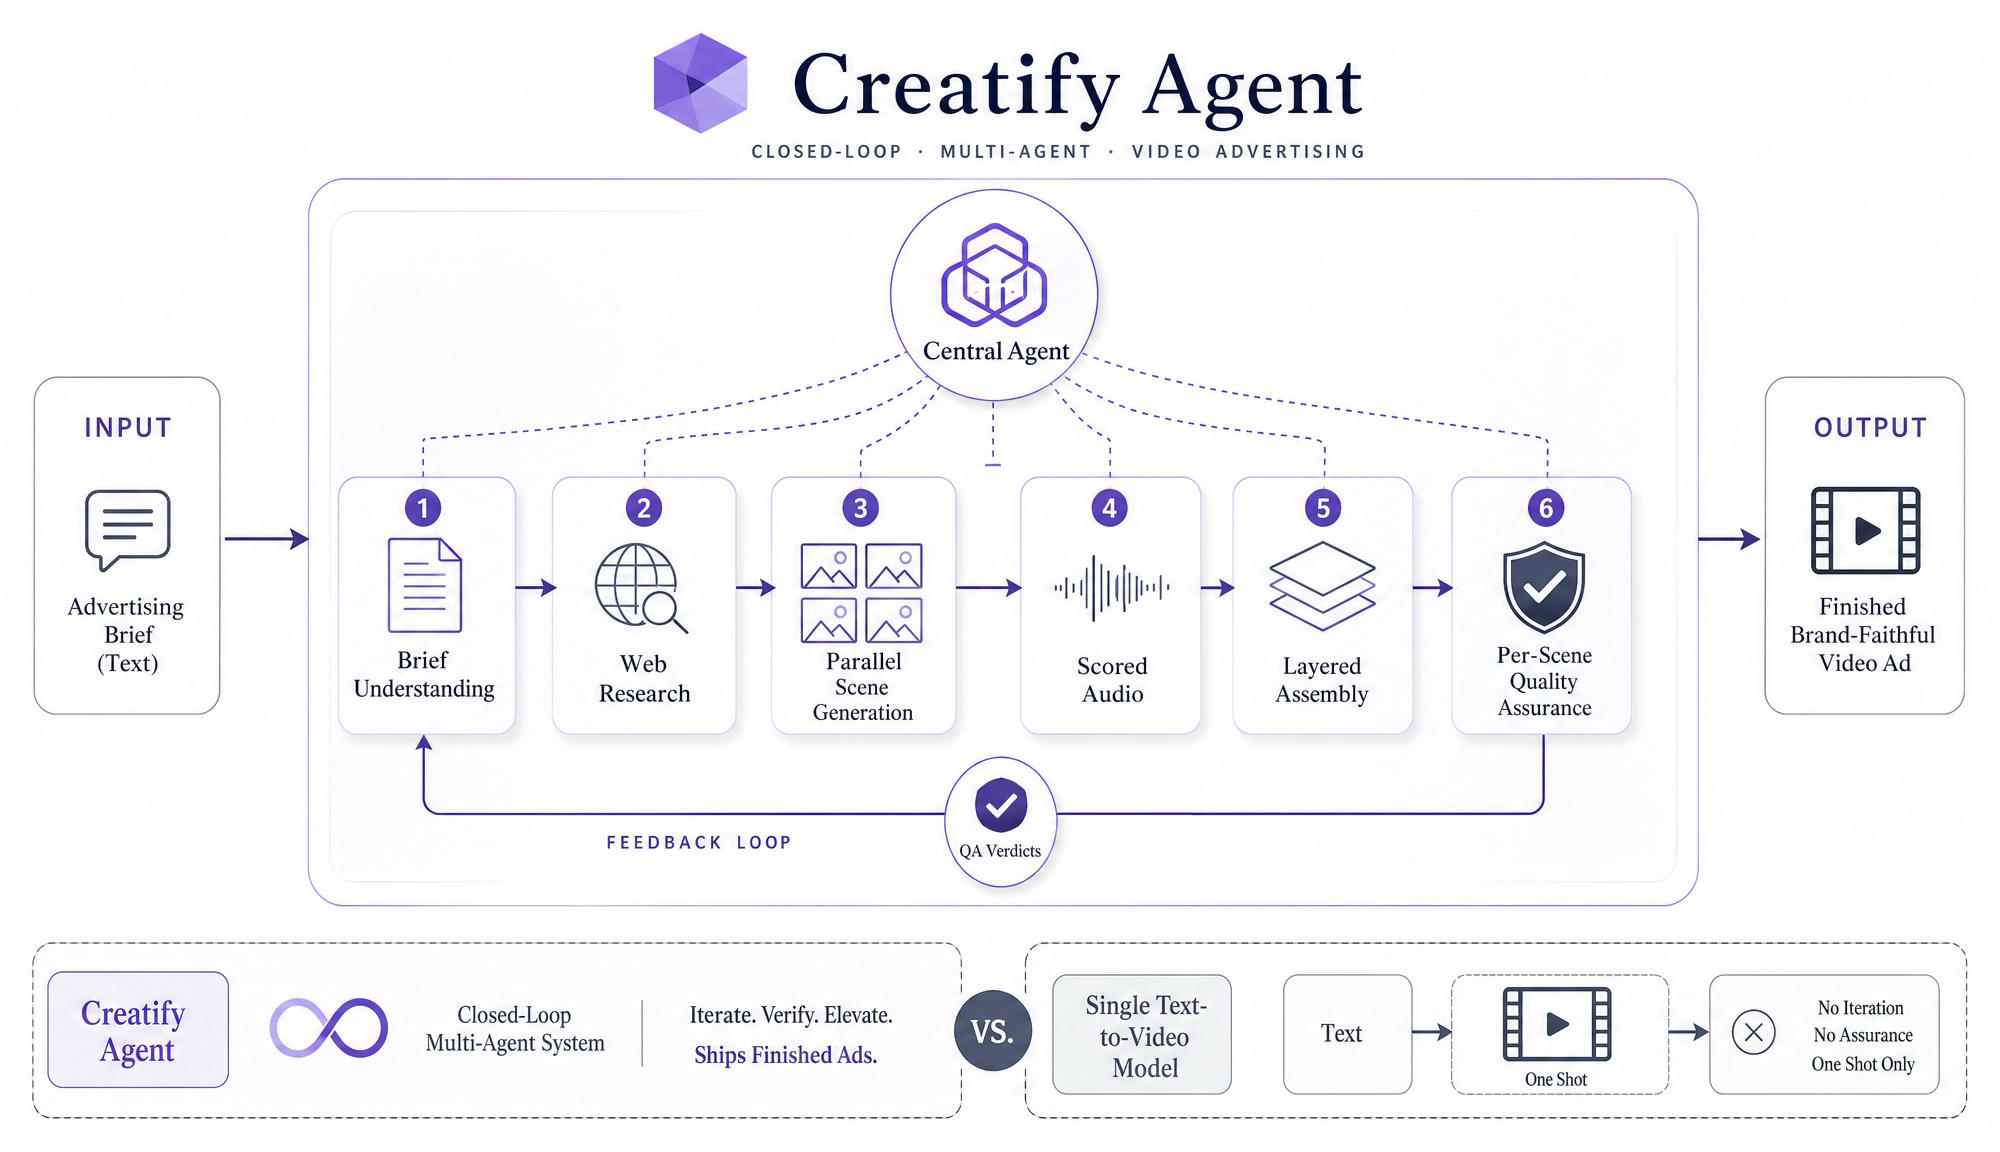
Creatify Agent 是专为视频和图片广告打造的闭环多智能体系统。只需一份创意 brief——通常只是一个产品链接或品牌参考——智能体就会规划整支广告,按镜头为每个场景选择并调度生成后端,配上音频,合成字体排版,并在交付前对照 brief 校验结果,最终交付一支完整且忠于品牌的广告。同样的闭环架构也用于生成图片创意:规划构图,为每个素材选择生成后端,并对照 brief 校验输出。该系统在结构上不同于最常与之比较的两类相近工具:一类是根据提示词生成单个短片段的文生视频基础模型,另一类是在对话界面背后封装单一模型的通用视频智能体。本报告介绍了系统架构,发布了 VideoAdAgent Bench v1——首个面向 AI 广告视频制作的公开基准测试——并给出核心结论:在决定成片广告能否投放的综合分、幻觉和成对偏好指标上,Creatify Agent 均优于通用视频智能体和前沿文生视频模型。
0.901
综合质量 · Creatify Agent Pro
位居第一。Lite 模式以 0.836 紧随其后;最强的非 Creatify 系统仅为 0.585。
95%
与原生文生视频的成对胜率
在与最强原生 T2V 基线的对比中,Pro 模式获得一致成对评判的比例。对通用视频智能体的胜率为 87%。
1.90
幻觉分 · Creatify Agent Pro
帧级评分标准,0–10(越低越好)。全场唯一低于 2.0 的系统;两个 Creatify 版本均低于生产级 FAIL 阈值 3.0(Lite 为 2.85)。
1 引言
效果广告创意——无论视频还是图片——在结构上都不同于前沿生成模型的输出。一支视频广告是 15 到 60 秒的多镜头成品,包含开场钩子、主体节奏、产品亮相、配乐、符合品牌的字体排版以及行动号召。基础 T2V 模型——Veo 3.1、Kling 3.0、Seedance 2.0、Sora 2——能以高视觉保真度渲染单个镜头,但无法表达多场景规划,无法校验跨剪辑的品牌一致性,没有按剪辑节奏配置的音频,也没有字体排版层。通用视频智能体在这类模型外包了一层对话界面,却继承了同样的缺口:它增加的是聊天入口,而不是决定成片广告能否投放的广告专用校验层。
Creatify Agent 不属于上述任何一类系统。它是一个编排层:以品牌和 brief 为输入,把工作分派给 brief 所需的各种生成模型、检索步骤、音频服务和校验环节。它按场景选择模型,而不是自己就是某一个模型。它在整个制作过程中维护类型化状态——品牌色、产品事实、角色身份、必需的屏幕文字——并在交付前对照这些状态校验每个场景,而不是直接信任生成器的首次输出。近期的智能体系统研究(Mora、VISTA、VideoReward)已形成共识:在决定成品质量的每个维度上,带有环内评审的多智能体分解都优于单模型生成;Creatify Agent 正是这一方向在广告领域的端到端落地,并在 §3 介绍的基准测试中与业内其他系统进行了对比评估。
2 系统设计
我们的智能体由多个专职子智能体组成闭环。制片人读取 brief,生成场景规划,并输出类型化的素材图谱:产品事实、角色描述、品牌状态、必需的屏幕文字。导演将场景规格转化为生成调用,按镜头选择模型和参数。评审依据明确的评分标准,对照素材图谱评估每个渲染出的场景,要么通过,要么附上结构化结论退回给导演——因此保真度不达标的场景只需在局部重新生成,而不必重做整支广告。交付之后闭环仍在继续:每支上线的广告都会被评分,每个缺陷都会成为回归用例,评分标准随每次制作不断收紧。
2.1 创意调研与参考锚定生成
在渲染任何场景之前,制片人可以先让 brief 立足于真实的创意语境。用户可以让智能体执行创意搜索——从 TikTok 和 Instagram 调取品牌所在品类中 8–10 支高效广告,并附带互动数据和开场钩子拆解——再把得到的形式作为分镜脚本的参考输入。这样,找出品类中行之有效的打法就成了用户可以直接发起的一等步骤,而不是一项单独的调研工作。另外两种方式也以同样的方式为 brief 提供依据。其一是 URL(例如 omakai.com):系统会抓取并解析其品牌信息——名称、理念、配色、主视觉——因此即使用户没有上传任何素材库,也能做出忠于品牌的广告。其二是参考视频——一支爆款 TikTok、一支竞品广告、一段现有的品牌短片——系统会把它拆解为有效要素(镜头节奏、色彩与光线、镜头语言、转场风格、屏幕文字节奏),再以此作为场景规划的依据。基础 T2V 模型和通用视频智能体都不具备这些能力:对它们来说,URL 只是一串字符,参考视频不受支持,而当下的创意趋势则在其训练数据截止时间之外。
2.2 持久品牌记忆
智能体会跨会话维护结构化记忆,按用户和品牌分别存储。产品事实(价格档位、核心卖点、禁止展示的内容)、品牌语调与配色、角色偏好以及过往成功的创意方向都会被自动保留;会话结束时的提炼步骤会提出值得长期保存的事实。用户第二次为同一品牌制作广告时,无需重新上传品牌套件、重新说明价格,也无需重新挑选配音。我们测试过的所有文生视频模型和通用视频智能体,每次调用都是从零开始。
2.3 可插拔技能与多版本扩展
制作技能是可插拔的。同一位制片人可以基于同一种 brief 格式,交付达人出镜的 UGC 广告、精致的产品演示、以角色为核心的用户证言(基于 Creatify 自研数字人模型 Aurora)、动态文字动效短片,或基于竞品调研的对比广告。结构化的素材图谱还支持以极低的边际成本从单个 brief 扩展出多个版本——不同的开场钩子、不同的角色、不同的画面比例——而无需重做整个制作,因为各个维度可以独立调整。
2.4 配乐
音频作为一等制作元素进行生成和卡点,而不是事后才混入。音乐按剪辑节奏生成;配音由 TTS 层单独渲染,语气和节奏贴合品牌;两者都在已知时间点合成到视频和文字图层上。基准测试中所有 Creatify 版本都带有配乐;所有原生文生视频基线都是无声的;HeyGen V3 只有数字人旁白。音频质量是不看 brief 的 Arm 3 评审打分最重的维度之一,这也在一定程度上解释了 Arm 3 中差距为何如此明显。
2.5 环内幻觉控制
评审是一个运行在制作闭环内的视觉模型,而不是事后过滤器。每个场景都会依据明确的评分标准对照类型化素材图谱进行评判——产品还原度、物体幻觉、文字质量、物理违背、人体结构、整体质量——不合格的场景会附上结构化结论(哪个维度、差多少、在哪一帧)退回,并带着这些反馈重新生成。评分标准和阈值是团队可以收紧的、人类可读的规则,而不是不透明的模型权重——这一设计思路在近期的智能体系统研究中已有阐述,包括将 harness 作为优化目标(Lee、Khattab、Finn 等)以及基于明确策略的批评-修改循环(Weng)。评审运行在专门针对广告失败模式打造的自研视觉技术栈上——品牌标识漂移、产品标签渲染错误、CTA 文字乱码、跨剪辑连贯性中断。基准测试结果是全场最低的帧级幻觉分:Creatify Agent Pro 为 1.90(唯一低于 2.0 的分数),Lite 为 2.85,均低于生产级 FAIL 阈值 3.0;所有原生 T2V 基线得分为 3.65–3.85,HeyGen V3 为 4.40。
3 基准测试
现有的视频质量基准(VBench、VBench-2.0、视频竞技场成对排行榜)衡量的是原生文生视频模型的逐帧保真度;没有一个衡量输出能否作为广告发挥作用,即决定能否投放的那些维度——开场钩子强度、品牌还原度、CTA 清晰度、广告效果、幻觉代价、制作完成度。VideoAdAgent Bench v1 正是为填补这一空白而建;完整排行榜、评审材料和复现脚本均已在基准测试页面公开。
3.1 Brief 集
该基准涵盖所有主要的效果广告模式——问题-解决方案、前后对比、产品演示、用户证言、生活方式——外加针对多场景制作最难维度的压力测试(主线叙事、角色一致性、品牌素材复用、结构化 CTA 文字、说服链路遵循度)。每个 brief 都是一个结构化对象(产品、意图、形式、约束、输入素材),使用虚构品牌和 AI 生成的产品样图,以规避真实客户的知识产权和个人信息。整套 brief 在任何系统生成输出之前就已预先登记到一个打了标签的提交中,因此没有系统能针对具体 brief 进行调优。
3.2 评估流程
该基准通过三个独立的成对评判组,分别回答三个相互正交的问题。每一组对比都由两位具备视觉能力的 LLM 评审(Claude Opus 4.7 + GPT-5)各评判两次,并互换位置以消除左右偏差;只有当评审在互换前后结论一致时才计入,且两位评审结论一致才算作一致结论。
| 组别 | 问题 | 对比组数 | 核心指标 |
|---|---|---|---|
| Arm 1 — 能力 | 该智能体是否优于其他智能体视频系统? | Creatify 对比所有通用视频智能体(HeyGen V3、Luma)。评审可以看到 brief。 | 对智能体竞品的胜率。 |
| 维度 2 — 广告质量 | 该智能体是否优于最强的原生 T2V 模型? | Creatify 对比 Veo 3.1、Kling 3.0、Seedance 2.0。每个模型采用两种基线配置:单场景(默认 API 调用——一条提示词,一段 8–12 秒片段)和多场景(按场景规划提示词后拼接)。评审可以看到 brief,并对八个广告质量维度打分;核心表格报告的是多场景配置的结果。 | 整体偏好(0–1)。 |
| Arm 3 — 视频制作质量 | 不考虑 brief,输出是否是质量更高的成品? | 与 Arm 2 使用相同的对比组,但评审看不到 brief。帧级幻觉评分以 3× 的权重与结构合规度合并计算。 | 视频质量分(0–1)。 |
排行榜上的综合分由 Arm 2(广告质量)和 Arm 3(制作质量)合成,因此系统必须在两个维度上都表现出色才能提升排名。帧级幻觉分(0–10,越低越好;≥ 3.0 即为生产级 FAIL)被纳入 Arm 3,并在排行榜上单列一栏公布。
4 结果
综合分显示 Creatify Agent 位居第一;两个已上线的版本在所有汇总指标上均超过所有通用视频智能体和所有原生 T2V 基线。所有系统——Creatify 及每个竞品——都在一次性条件下评分:输入一份 brief,输出一支广告,没有反馈轮次。Creatify Agent 的线上版本支持对话式交互和精准的逐场景修改;基准测试刻意去掉了这一能力,以确保与单次生成模型的比较公平,这意味着实际使用体验会优于此处报告的数据。
| 排名 | 系统 | 综合 | Arm 1 | Arm 2 | Arm 3 | 幻觉 ↓ |
|---|---|---|---|---|---|---|
| 1 | Creatify Agent · Pro | 0.901 | 0.732 | 0.775 | 0.855 | 1.90 |
| 2 | Creatify Agent · Lite | 0.836 | 0.716 | 0.757 | 0.778 | 2.85 |
| 3 | Luma Agent | 0.585 | 0.580 | 0.603 | 0.741 | 3.20 |
| 4 | HeyGen V3 Agent | 0.327 | 0.358 | 0.378 | 0.609 | 4.40 |
| 5 | Seedance 2.0(多场景) | 0.312 | — | 0.337 | 0.588 | 3.65 |
| 6 | Kling 3.0(多场景) | 0.301 | — | 0.365 | 0.585 | 3.80 |
| 7 | Veo 3.1(多场景) | 0.287 | — | 0.362 | 0.549 | 3.85 |
5 案例研究
以下是三个真实的线上产品输出,与最强的商业替代方案(一个基础 T2V 模型、一个通用视频智能体)使用相同的提示词生成,未为本报告做任何挑选。每个案例都展示了智能体的一项不同能力——brief 拆解、品牌素材锚定、网络调研——这些都是单次生成无法实现的。
5.1 多镜头烹饪广告
20 秒 TikTok 烹饪广告,约 50 个镜头,每个约 0.4 秒。对比 Veo 3.1(单镜头 T2V)和 HeyGen V3(通用视频智能体)。
提示词"make a super fast paced, .4 second multi shot cooking video making chicken pesto pasta. full video is 20 seconds"
制片人将提示词解析为镜头清单,拆解为约 50 个镜头并行分派给各场景导演,并按剪辑节奏配乐。Veo 3.1 的 API 没有设置总时长或多镜头结构的参数(单次调用最长 8 秒,只输出一条镜头)。HeyGen V3 则把提示词当作数字人的旁白内容,而不是镜头规格。
5.2 以品牌图片为锚点的 Instagram 广告
用户上传一张 TopStep 品牌参考图,要求制作一支徒步者登顶的 Instagram 广告。对比 Veo 3.1 图生视频(以品牌图片作为首帧)和 HeyGen V3(仅支持提示词——不支持图片输入)。
提示词"Create an Instagram carousel ad set for TopStep @input:image-1 using the reference image and inserting a hiker making his way up to mountain with the goal of getting to the top of the mountain"
参考图片被纳入类型化素材图谱,并锚定每个场景:品牌色贯穿始终,品牌标识在结尾卡上作为经过校验的文字图层呈现,徒步者角色在"出发→攀登→登顶"的弧线中保持一致。Veo 3.1 能在一条 8 秒镜头内保留首帧,但无法表达多场景弧线。HeyGen V3 的 API 只接受提示词字符串,因此品牌图片没有被使用。
5.3 仅凭 URL 的 brief,无上传素材
用户只粘贴了一个 URL;智能体抓取网站,提取品牌信息,并自行撰写 brief。两个基线都无法访问网络。
提示词"Create a vertical TikTok video ad for https://omakai.com/"
OMAKAI 是迈阿密的一家 omakase 寿司餐厅。制片人的网络检索步骤会抓取 omakai.com,提取品牌名称、omakase 理念和迈阿密定位,然后在任何生成调用之前先为分镜脚本打好基础。两个基线都没有网络检索能力:Veo 3.1 根据提示词字符串生成的餐厅画面视觉上尚可,但内容泛泛;HeyGen V3 则直接把 URL 当作配音台词念出来。在线上产品中,仅凭 URL 的 brief 是中小企业上手时最常见的场景。
6 局限性
幻觉很低,但并非为零。两个 Creatify 版本都低于生产级幻觉阈值(Pro 为 1.90,Lite 为 2.85),但仍有一小部分 Pro 生成的广告存在评审未发现的轻微品牌文字抖动或细微的跨镜头不一致。将这部分残余降至零是我们正在积极研究的方向。
仅限一次性评估。该基准评分的是输入一份 brief、输出一支广告,没有反馈轮次。线上智能体支持对话;用户指出残留缺陷("第 3 个场景的价格不对")后,系统会带着修正意见对该场景进行精准的局部重新生成。通过交互式反馈可达到的幻觉率明显低于此处报告的一次性数据,但不在本报告的研究范围内。
7 可复现性
本报告中的每一项结论都可以通过公开的基准测试复现,该基准已随本次发布在 github.com/creatify-ai/VABench 开源。其中包含 brief 集、数据结构、评审提示词、评分标准、运行框架和汇总脚本。brief 集在任何系统生成输出之前就已预先登记到一个打了标签的提交中,因此基准中的任何系统都不可能针对具体 brief 进行调优。
8 相关工作
- 多智能体视频生成:Mora、VideoDirectorGPT、FilmAgent、StoryAgent、VISTA。
- 视频质量基准:VBench / VBench-2.0;VideoGen-Eval;用于成对位置偏差控制的 Artificial Analysis Video Arena。
- 视频奖励建模:VideoReward / Flow-DPO、UnifiedReward。
- 广告专用评分标准:Springboards Creativity Benchmark、AdsQA、Pitt Ads Dataset,以及用于前 3 秒评估的"Decoding the Hook"。
- 闭环质量保证:Meta-Harness(Lee、Khattab、Finn 等);Learning Beyond Gradients(Weng),探讨基于明确策略的批评-修改循环。