
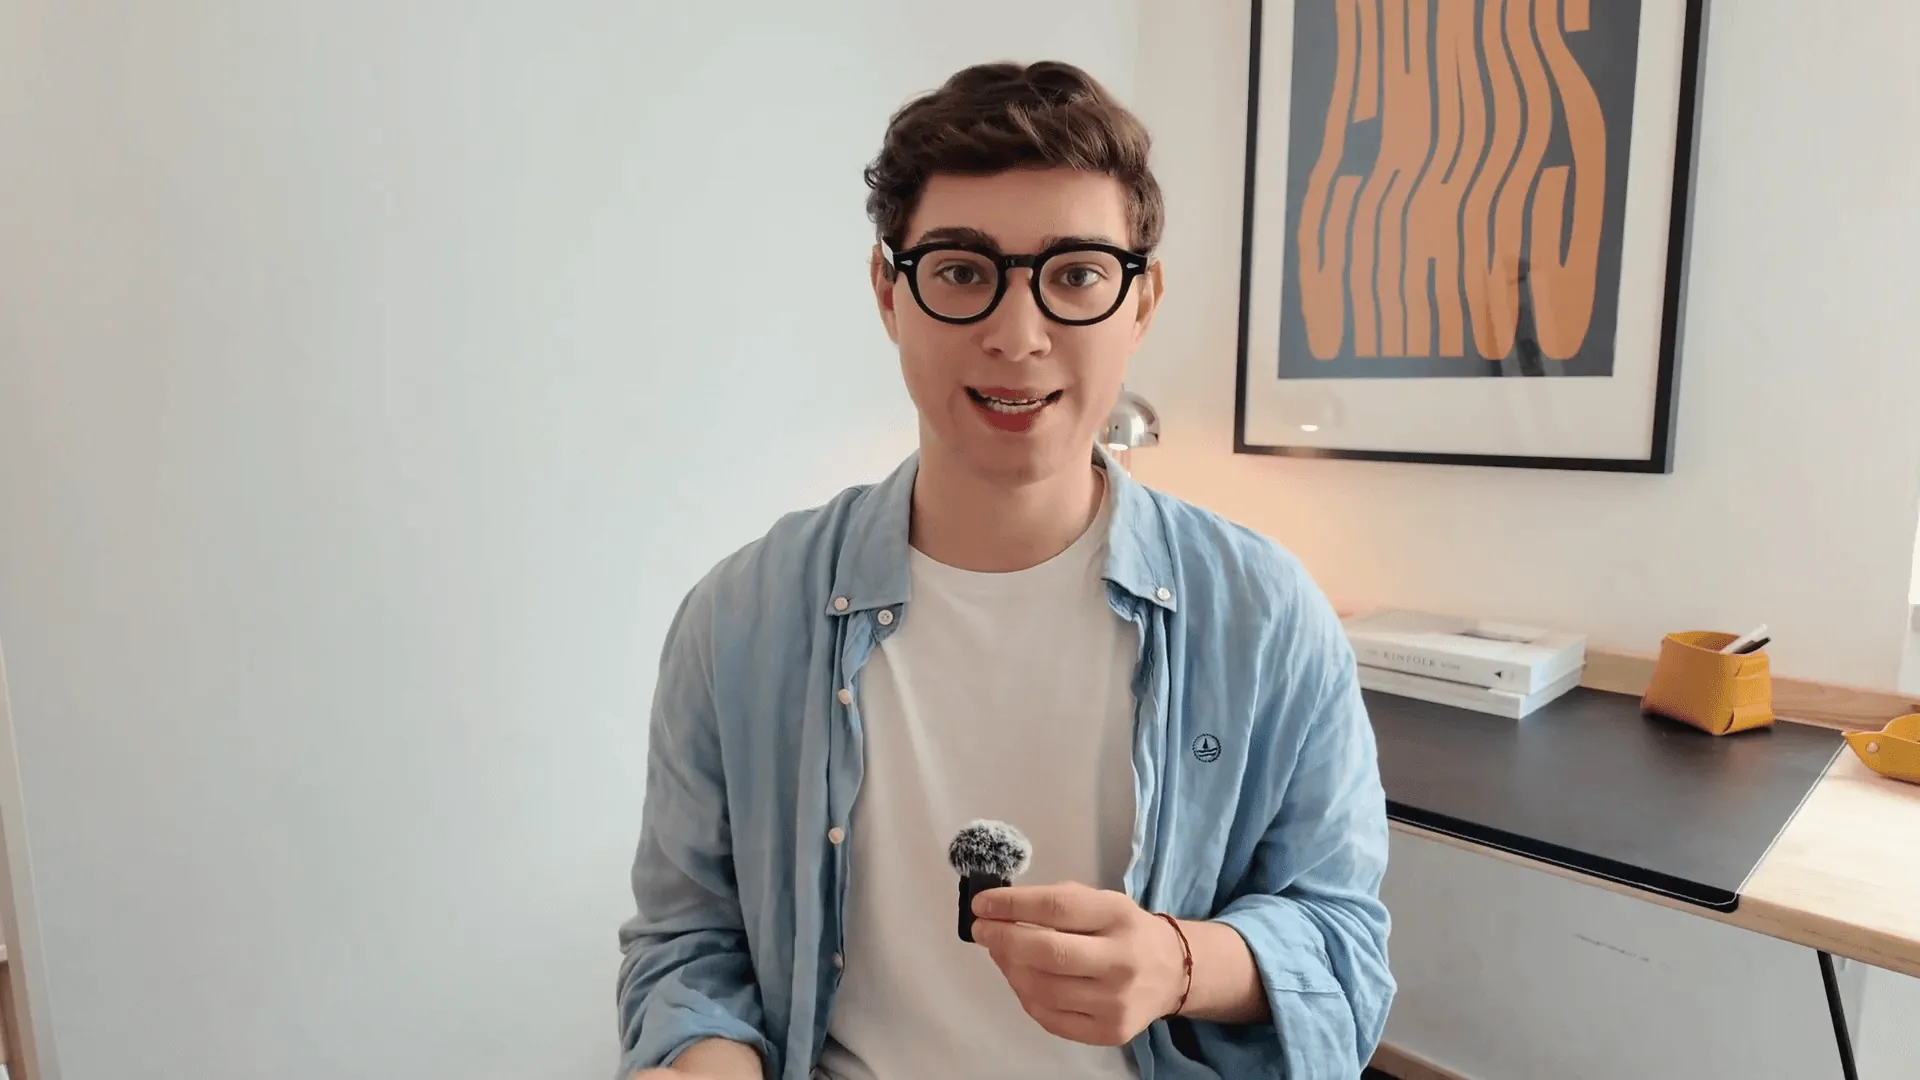
Aurora——音频驱动的超现实反应头像渲染——是生成式人工智能的突破,实现了广告商、营销人员和内容创作者寻求的图像栩栩如生的效果,专为他们设计,提供专业级工作室级别视频质量。给Aurora一张单人的照片(可以是真人或AI生成的)和一段语音或歌曲的音频片段,Aurora将生成该人说话或唱歌的高保真工作室质量视频。这种用于头像合成的多模态基础模型是专为我们的核心用户群——广告商、营销人员和内容创作者——打造的,提供超现实的表现型头像,能像真人一样移动和表达情感。
想象一下,一张静态肖像突然微笑、眨眼,并高声歌唱——仅凭一张图片和一个音频文件。Aurora使这一切成为可能,开创了内容创作和虚拟叙事的新领域。
通过与其他方法的基准测试,我们发现Aurora具有以下优势:
- 顶尖的数字人逼真度:提供出色的视觉保真度和自然感,具备高度精准的面部表情、口型同步、情感细节、呼吸、眨眼、手势和全身动作。
- 情感丰富且情境感知:能够准确地解释语音音调和语调,以传达适当的情感表现并同步手势,增强头像表现的真实性。
- 可扩展且一致的音频推理:支持长篇音频输入,同时保持高质量角色一致性,确保视觉和行为一致性,即使跨数分钟的对话也能实现。
- 强大的跨场景性能:优化以在多种使用场景中可靠表现,包括播客风格的对话、侧面角度演示、音乐演出和风格化角色动画。
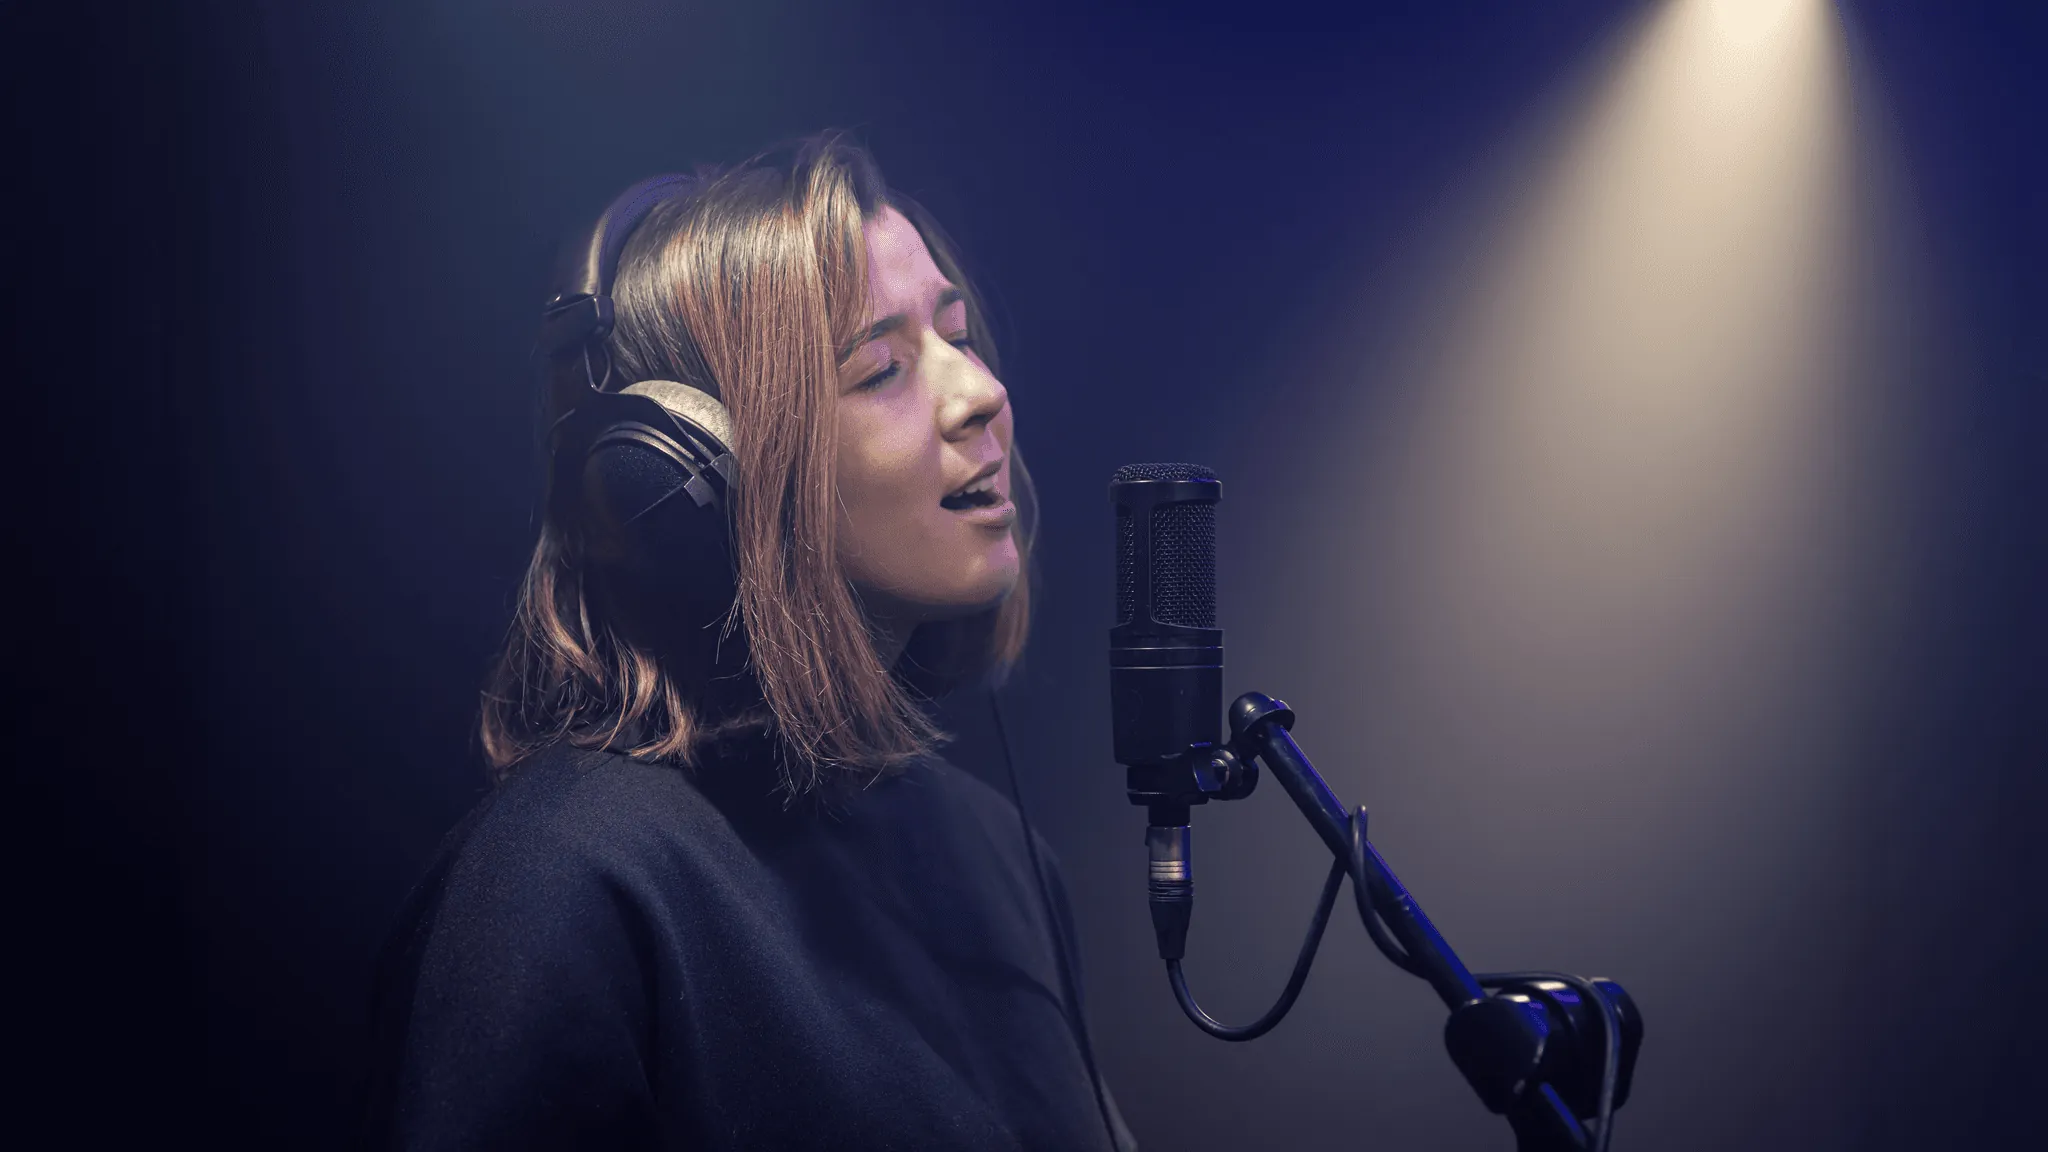
扩散驱动的现实主义
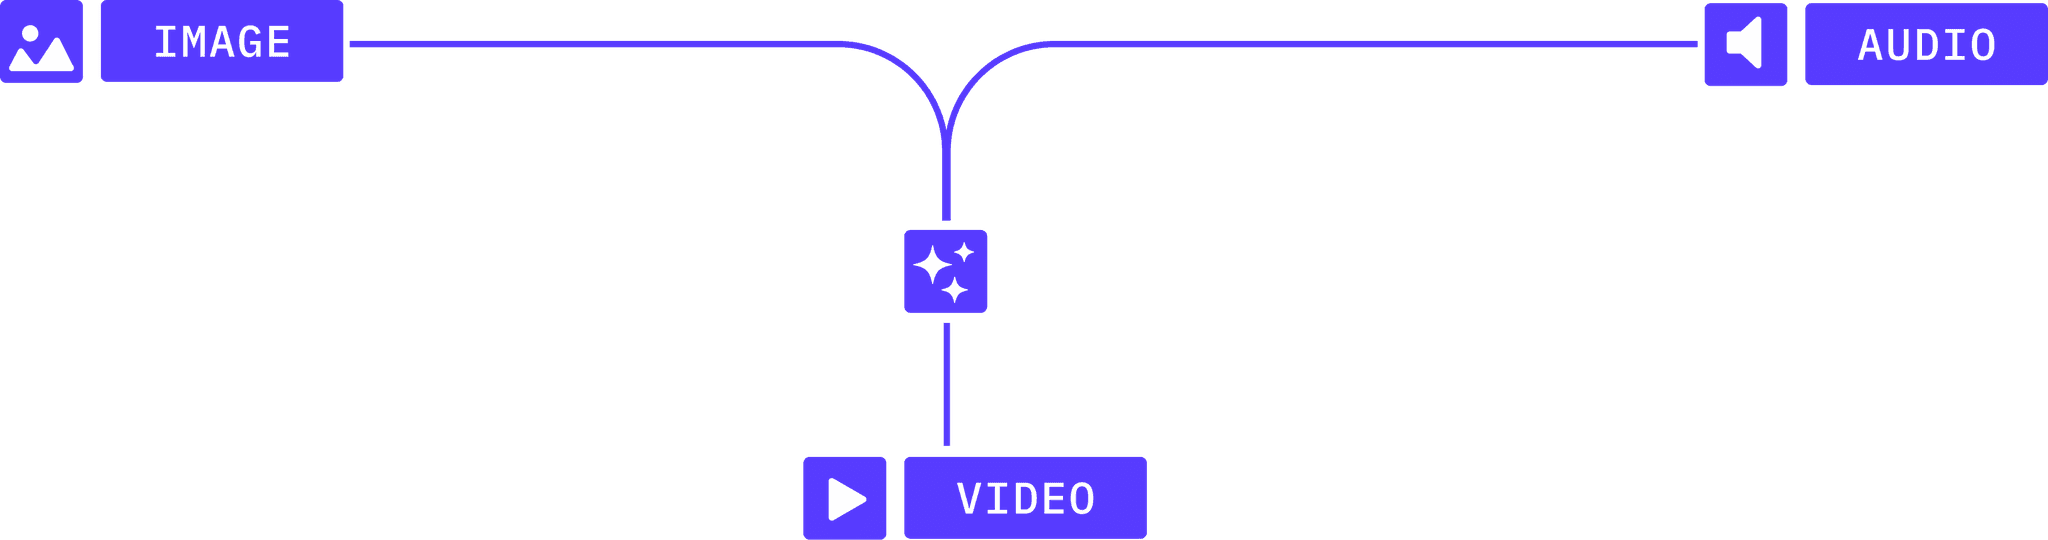
在Aurora的核心是一个基于扩散的多模态基础模型,专为生成性头像合成而设计。我们采用了一种新颖的架构,包括图像编码器、文本编码器和音频编码器,以处理来自不同模态的信息。我们将所有这些信息融合在一起,以生成与音频和文本输入相一致的头像动作。为了确保有效的融合,我们设计了一个特殊的模态信息交换通道,以便所有模态在潜在空间中得到良好的对齐和整合。这种新型架构使我们的模型能够捕捉到人类表情中的细微细节。它利用音频中的情感线索来生成反映自然人类反应的视觉输出。
扩散模型通过逐步完善图像来合成视频,这有助于Aurora在每一帧中保持写实的细节和时间上的连贯性。其结果是平滑自然的运动,没有以前方法中出现的刺眼故障或不自然的伪影。从微妙的眨眼到皮肤和头发的质感,Aurora的逼真度由最先进的生成科学提供动力。早期测试者对Aurora生成的视频是多么自然和富有表现力感到惊讶,即便是与真实镜头相比也是如此。头像会在合适的时刻保持眼神交流和手势动作,同时与原始照片中的人高度相似。对于广告商和创作者来说,这种程度的逼真性至关重要——当视觉效果真实时,观众会保持沉浸和参与,这在营销视频中尤其有利。
富有表现力的动作和手势
Aurora与之前的唇同步模型的关键区别在于,Aurora不仅仅是唇同步——它将完整的人类表达带入数字化身。生成的化身展现出栩栩如生的面部表情、头部动作,甚至还有上半身的手势——例如,他们可能会抬眉、点头,或在说话时用手加重语气。这些细微差别使化身的表现感觉真实而引人入胜。
传统的谈话头生成器往往显得静态或仅仅移动嘴巴,而Aurora则能动画化整个形象。化身可以转移视线,自然眨眼,并在与语音同步时进行逼真的手部动作。这种表现力的水平意味着Aurora的化身能够超越语言进行交流,通过肢体语言传达语气和情感。每一个微笑、皱眉或耸肩动作都是根据上下文生成的,因此结果是一个在摄像头前表现得像真实人物而不是动画木偶的化身。凭借如此逼真的动作,Aurora化身甚至可以在商业广告中作为令人信服的屏幕代言人,以人类般的真实性传达品牌的信息。
一张照片,无限表现
Aurora 最令人惊叹的功能之一是您只需一张图像即可创建视频。只需一张照片作为参考,Aurora 就能够生成一个连贯且逼真的视频,其中该人物可以根据您的音频或文本脚本进行说话或唱歌。不需要捕捉多个角度或在人物的数小时影片上训练模型——Aurora 可以零样本工作:只需上传一张图片以及音频片段或脚本,模型将完成其他工作。
尽管只有一张图像,模型仍能在每一帧中保持角色的身份和外观。凭借 Aurora 的设计,头像的面部和身体都能够保持原型(不会变形为其他人或偏离原型)。无需特定设置,普通智能手机照片甚至是 AI 绘制角色肖像,就足以释放 Aurora 的潜力。这极大地降低了任何人的门槛——从独立创作者到市场团队——可以创建高质量的头像视频——仅需选择图片,添加音频片段,然后让 Aurora 生成表演即可。
解锁新的创意可能性
Aurora 的超真实音频驱动化身为无数应用程序打开了大门。以下是广告商、市场营销人员和创作者可以使用 Aurora 的几种方式:
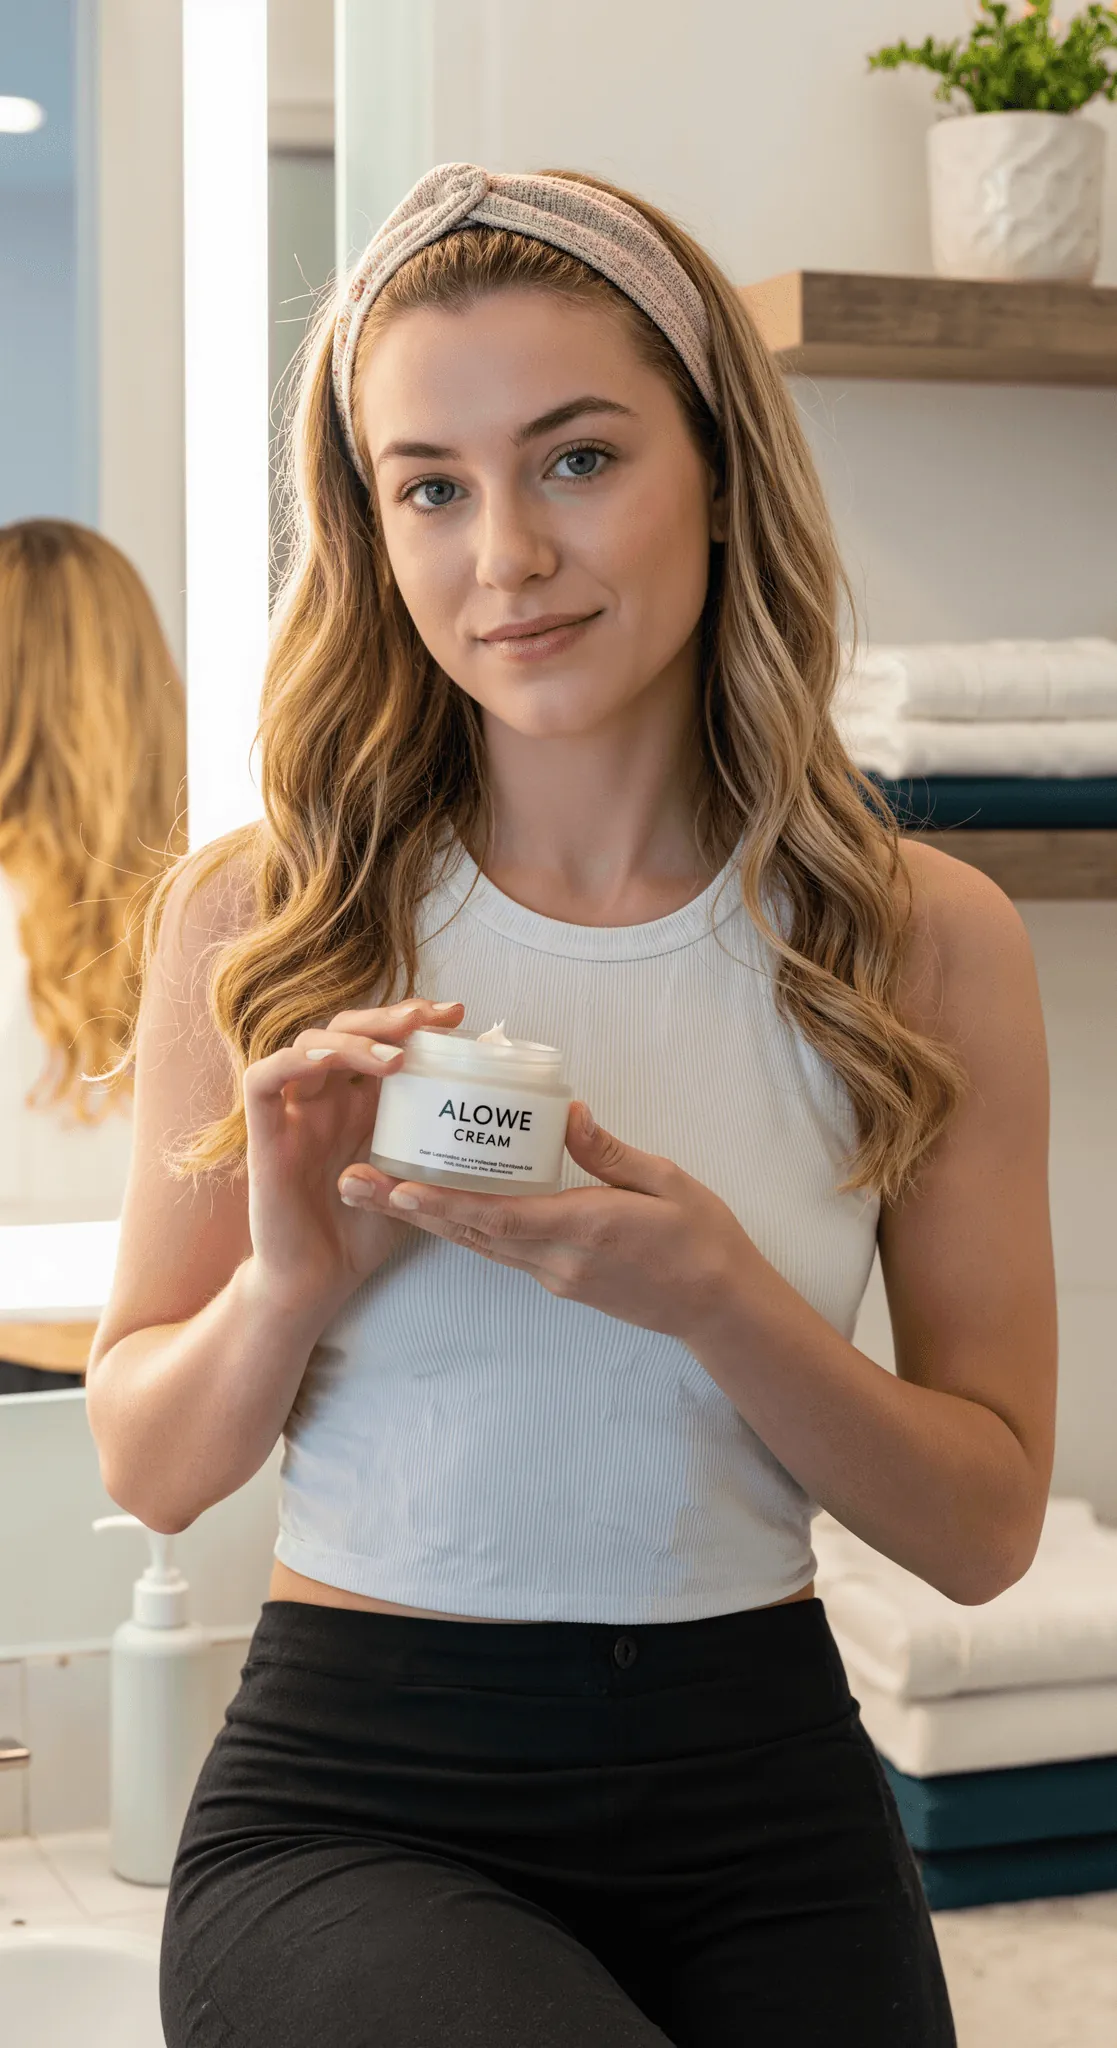
- 广告与市场营销:市场营销人员和广告商可以轻松生成专业级视频广告,带有栩栩如生的化身。借助 Aurora,一张产品照片或代言人的图像可以转换为社交媒体或数字活动的动态广告。超真实化身抓住了观众的注意力,使广告内容更加引人入胜和有效。
- 内容创作:视频创作者可以快速将剧本和一张头像转换为引人入胜的谈话头视频。这对于希望为角色赋予生命而无需聘请演员或租用工作室的 YouTuber、讲故事者或独立电影制片人来说,是理想选择。
- 虚拟人类:为 VR、游戏或客户服务构建互动的数字人类。Aurora 可以为虚拟主持人、主播或网红提供动力,使其看起来并表现得像真实的人物。他们会自然地做手势、表达情感和对话,增强虚拟环境中的沉浸感。
- 配音与本地化:在保留屏幕上说话者的嘴唇和表情与新音频完美同步的情况下,将视频配音成不同语言。Aurora 可以采用原始电影场景或演示,并用另一种语言重新生成视频,使多语言内容无缝对接。
- 教育:从单张图像中赋予历史人物或讲师生命。学生可以观看阿尔伯特·爱因斯坦解释相对论,或听著名作者朗读他们的作品,配以生动的唇同步和手势,使体验难以忘怀。Aurora 可以将静态教育资料转变为引人入胜的视觉课程。
- 歌唱化身与音乐:将专辑封面或歌手的照片转化为音乐视频。音乐家和粉丝可以创建演唱任何歌曲的歌唱化身,实现虚拟音乐会或歌词视频,其中屏幕上的歌手是由 AI 驱动的化身。这是一种全新的音乐可视化方式,化身的表演完全由歌曲的音频驱动。
Aurora引领着一个新时代,创建一个真实的说话视频就像拥有一张照片和一些想说的话一样简单。
我们的目标是突破超真实化身动画的极限,使图像中的人看起来真正活着、富有表现力,并在视频中交流。我们很高兴为那些想要利用这一能力的创作者、广告商和市场营销者推出Aurora。我们相信这将是一个讲故事、沟通、数字营销和创新的强大工具。我们迫不及待地想看到你将用它创造什么,并热切期待在你的反馈下继续改进这个模型。
现实与虚拟之间的界限不断模糊,有了Aurora,你的数字形象可以像真人一样生动地说话。对于我们的营销合作伙伴来说,这意味着能够提供捕捉观众注意力并提高活动效果的超真实视频内容。毕竟,最高质量的视频通常会导致广告的更好转化率。欢迎来到自然和富有表现力的化身的未来!