Creatify Agent:動画・画像広告クリエイティブのためのクローズドループ型マルチエージェントシステム
Creatify Research · 2026-05-15
概要
Creatify Agentは、動画・画像広告のために設計されたクローズドループ型のマルチエージェントシステムです。商品URLやブランドのリファレンスだけということも多い1つのクリエイティブブリーフから、エージェントが広告を企画し、ショットごとに選んだ生成バックエンドへ各シーンを割り当て、音声を付け、タイポグラフィを合成し、ブリーフに照らして結果を検証したうえで、ブランドに忠実な完成済みの広告を納品します。同じクローズドループのアーキテクチャで画像クリエイティブも制作し、構図を設計し、アセットごとに生成バックエンドを選び、出力をブリーフに照らして検証します。このシステムは、よく比較される隣接した2種類のツール、すなわちプロンプトから短いクリップを1本生成する基盤text-to-videoモデルや、単一モデルを対話型UIで包んだ汎用動画エージェントとは、構造的に異なります。本レポートでは、そのアーキテクチャを解説し、AI広告動画制作のための初の公開ベンチマークであるVideoAdAgent Bench v1を紹介するとともに、主要な結果を報告します。Creatify Agentは、完成した広告が配信可能かどうかを左右する総合スコア、ハルシネーション、ペア比較の選好という指標において、汎用動画エージェントや最先端のtext-to-videoモデルを上回りました。
0.901
総合品質 · Creatify Agent Pro
業界トップ。Liteモードが0.836で続き、Creatify以外で最も高いシステムは0.585にとどまります。
95%
生のtext-to-videoモデルとのペア比較勝率
最も強力な生のT2Vベースラインとのペア比較のうち、判定が一致したものでProモードが勝利した割合。汎用動画エージェントに対しては87%です。
1.90
ハルシネーションスコア · Creatify Agent Pro
フレーム単位のルーブリック、0–10(低いほど良い)。2.0を下回ったのはこのシステムだけです。Creatifyの両バリアントとも、本番品質のFAIL閾値3.0をクリアしています(Liteは2.85)。
1 はじめに
パフォーマンス広告のクリエイティブは、動画であれ画像であれ、最先端の生成モデルが出力するものとは構造的に異なります。動画広告は15〜60秒のマルチショットの成果物であり、フック、本編の展開、商品を見せる場面、音声、ブランドに沿ったタイポグラフィ、CTAで構成されます。Veo 3.1、Kling 3.0、Seedance 2.0、Sora 2といった基盤T2Vモデルは、1ショットを高い映像品質でレンダリングしますが、マルチシーンの構成を表現する仕組みも、カットをまたいだブランド要素の検証も、カットのリズムに合わせた音声も、タイポグラフィのレイヤーもありません。汎用動画エージェントはこうしたモデルを対話型インターフェースで包んでいるものの、同じ欠点を引き継いでいます。追加されるのはチャット画面であって、完成した広告が配信可能かどうかを判断する広告特化型の検証レイヤーではありません。
Creatify Agentはそのどちらでもありません。ブランドとブリーフを入力として受け取り、ブリーフに必要な生成モデル、検索ステップ、音声サービス、検証プロセスに作業を振り分けるオーケストレーションレイヤーです。自らが1つのモデルなのではなく、シーンごとにモデルを選択します。ブランドカラー、商品情報、ペルソナのアイデンティティ、必須の画面上テキストといった型付きの状態を制作全体を通じて保持し、生成モデルの最初の出力を鵜呑みにせず、納品前に各シーンをその状態に照らして検証します。近年のエージェントシステム研究(Mora、VISTA、VideoReward)は、ループ内に批評役を置いたマルチエージェント分解が、完成した成果物を左右するあらゆる観点で単一モデルによる生成を上回るという結論に収束しつつあります。Creatify Agentはその方向性を広告向けにエンドツーエンドで特化させた実装であり、§3で紹介するベンチマークで他のシステムと比較評価しています。
2 システム設計
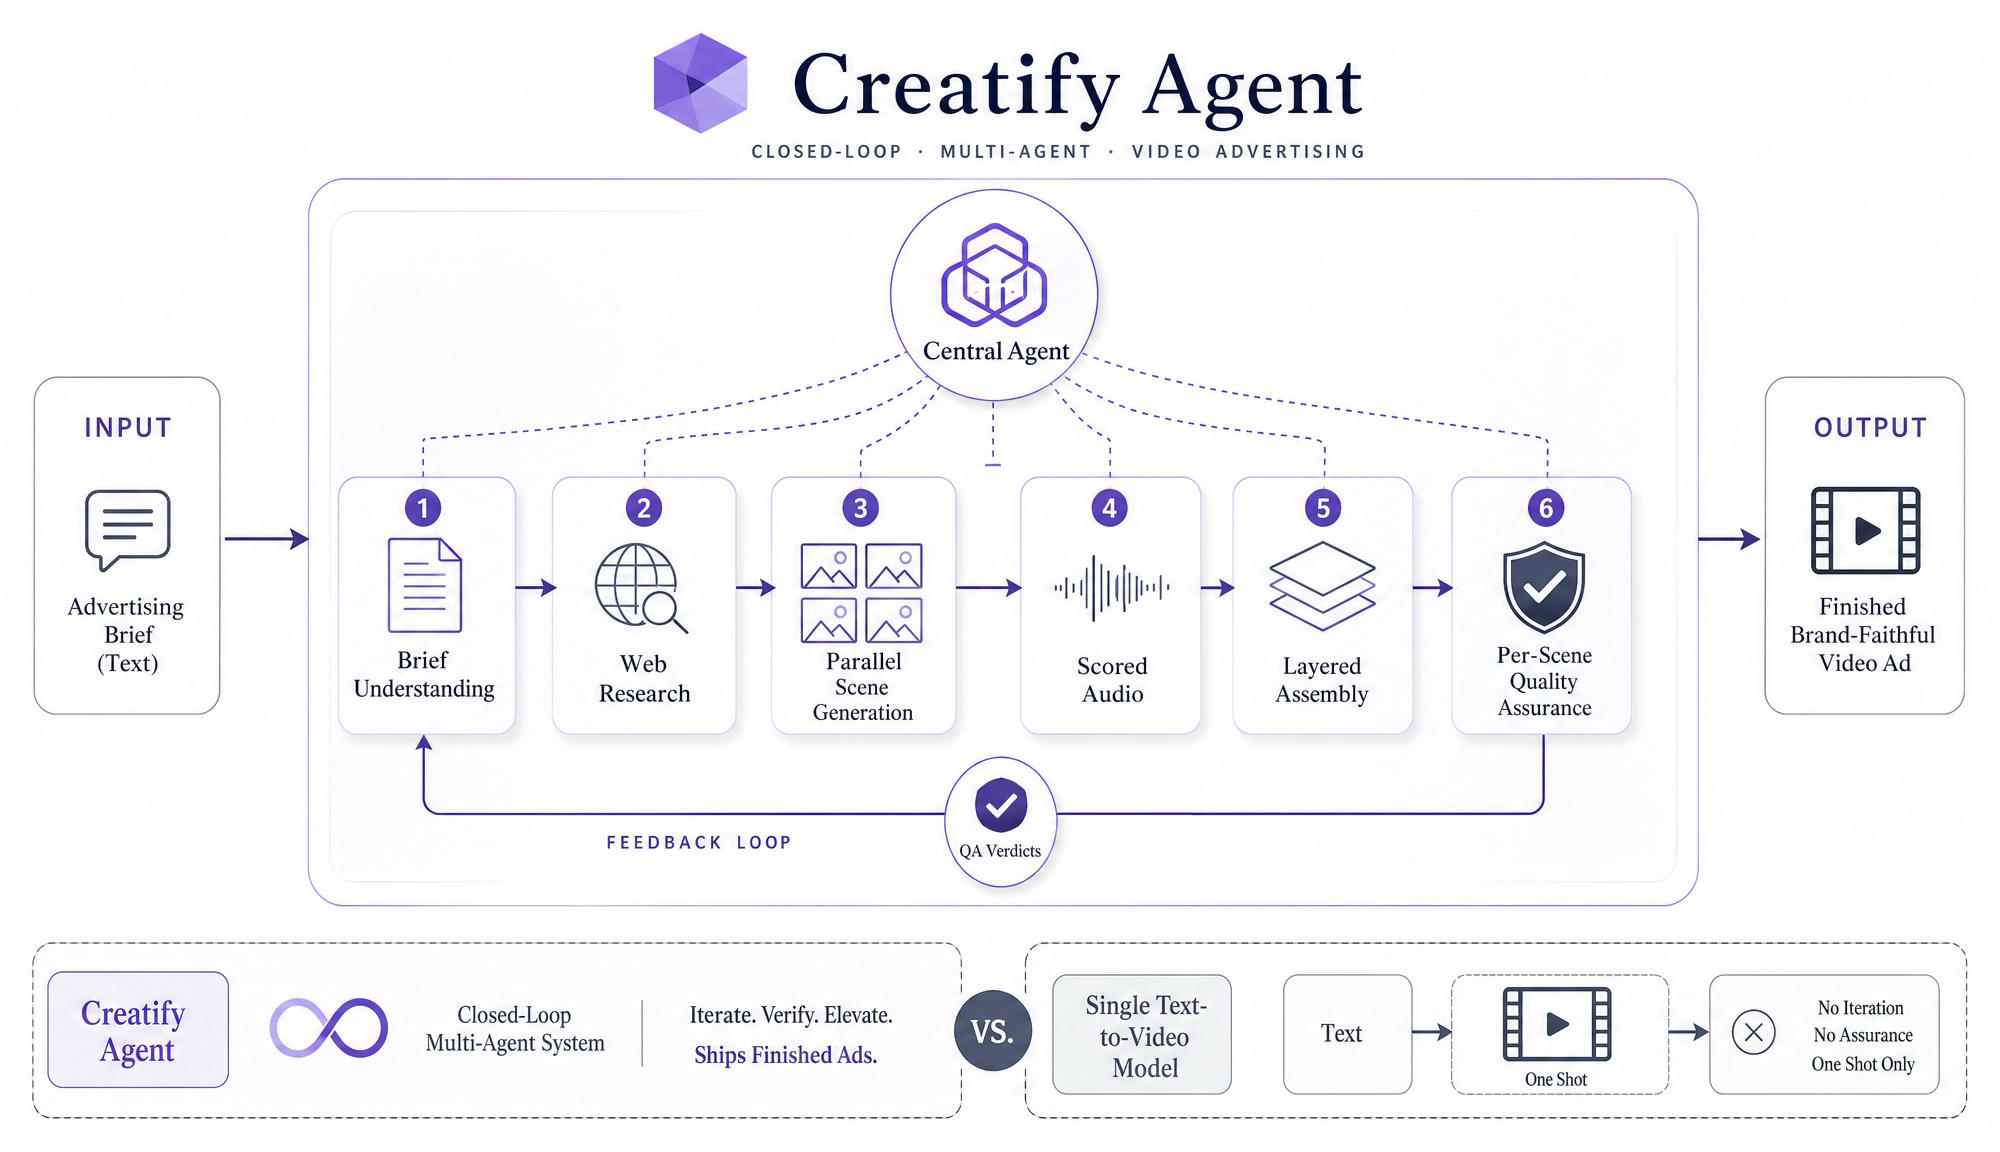
当社のエージェントは、専門化されたサブエージェントによるクローズドループとして動作します。プロデューサーがブリーフを取り込み、シーン構成を導き出し、商品情報、ペルソナの記述、ブランドの状態、必須の画面上テキストからなる型付きのアセットグラフを出力します。ディレクターはシーン仕様を生成呼び出しに変換し、ショットごとにモデルとパラメータを選択します。クリティックはレンダリングされた各シーンを明確なルーブリックに沿ってアセットグラフと照らし合わせて評価し、承認するか、構造化された判定を付けてディレクターに差し戻します。そのため、忠実度で不合格となったシーンは広告全体を作り直すことなく、そのシーンだけが再生成されます。ループは納品後にも閉じられます。配信されたすべての広告が採点され、すべての欠陥が回帰テストケースとなり、制作を重ねるごとにルーブリックが厳密になっていきます。
2.1 クリエイティブリサーチとリファレンスに基づく生成
プロデューサーは、シーンをレンダリングする前に、実際のクリエイティブの文脈に基づいてブリーフを固めることができます。ユーザーはエージェントにクリエイティブ検索を依頼でき、エージェントはTikTokとInstagramからブランドのカテゴリーで成果を上げている広告を8〜10本取得し、エンゲージメントのメタデータとフックの分解結果とともに返します。その結果得られたフォーマットをストーリーボードのリファレンスとして入力できるため、カテゴリーで何が効果を上げているかの把握が、別途リサーチを行うことなく、ユーザーが依頼できる正式なステップになります。さらに2つのモダリティでも、同じようにブリーフを補強できます。URL(例:omakai.com)を取得・解析してブランド名、コンセプト、カラーパレット、メインビジュアルといったブランドアイデンティティを抽出するため、アセットライブラリをアップロードしていないユーザーでもブランドに忠実な広告を制作できます。リファレンス動画(バイラルになったTikTok、競合の広告、既存のブランドリールなど)は、ショットのリズム、色と照明、カメラワーク、トランジションのスタイル、画面上テキストのテンポといった効果的な要素に分解され、シーン構成の土台となります。これらのモダリティはいずれも、基盤T2Vモデルや汎用動画エージェントでは利用できません。それらにとってURLは単なる文字列にすぎず、リファレンス動画には対応しておらず、トレンドのクリエイティブの文脈は学習データのカットオフ以降のものだからです。
2.2 永続的なブランドメモリ
エージェントは、ユーザーごと・ブランドごとに紐づいた構造化メモリをセッションをまたいで保持します。商品情報(価格帯、主要機能、表示NGの項目)、ブランドボイスとカラーパレット、ペルソナの好み、過去に成功したクリエイティブの方向性は自動的に保存され、セッション終了時の要約ステップで、長期的に残すべき情報が提案されます。同じブランドの広告を再度依頼する際、ブランドキットの再アップロード、価格帯の再説明、ボイスの選び直しは必要ありません。私たちがベンチマークしたテキストから動画へのモデルや汎用動画エージェントは、いずれも毎回ゼロから始まります。
2.3 プラグイン型スキルとマルチアウトプット展開
制作スキルはプラグイン型です。1つのプロデューサーが、同じブリーフ形式から、クリエイター主導のUGC広告、洗練された製品デモ、ペルソナを軸にした推薦動画(Creatify独自のアバターモデルAuroraで構築)、キネティックタイポグラフィによるモーションデザイン動画、競合調査に基づく比較広告を制作できます。また、構造化されたアセットグラフにより、1つのブリーフから低い限界コストで複数の出力へ展開できます。フック違い、ペルソナ違い、アスペクト比違いなど、各要素を個別に変更できるため、制作全体をやり直す必要はありません。
2.4 オーディオスコアリング
オーディオは後付けで合成するのではなく、制作の中核要素として生成・タイミング調整されます。音楽トラックはカットのリズムに合わせて生成され、ナレーションはブランドに合ったトーンとテンポでTTSレイヤーから個別にレンダリングされます。両者は既知のオフセットで映像とタイポグラフィのレイヤーに合成されます。ベンチマークにおけるCreatifyの全バリアントはスコアリング済みオーディオ付きで出力される一方、素のテキストから動画へのベースラインはすべて無音で、HeyGen V3はアバターのナレーションのみです。オーディオ品質は、ブリーフなしのアーム3で審査員が特に高く評価する項目の1つであり、アーム3で明確な差が出た理由の一端となっています。
2.5 制作ループ内でのハルシネーション制御
クリティックは事後フィルターではなく、制作ループ内で動作する画像認識対応モデルです。各シーンは型付きアセットグラフに照らして、製品の忠実度、オブジェクトのハルシネーション、テキスト品質、物理法則の破綻、人体構造、全体的な品質という明確な評価基準で判定されます。不合格の場合は、どの項目が、どの程度、どのフレームで問題なのかを示す構造化された判定とともに差し戻され、そのフィードバックを組み込んで再生成されます。評価基準としきい値は、不透明なモデルの重みではなく、チームが厳格化できる人間が読めるルールです。これは、最適化対象としてのハーネス(Lee、Khattab、Finnら)や、明示的なポリシーに基づく批評・修正ループ(Weng)といった近年のエージェントシステム研究で示された設計思想に沿ったものです。クリティックは、ロゴのずれ、製品ラベルの誤描画、崩れたCTA、カット間の連続性の破綻など、広告特有の失敗パターンに特化した独自の画像認識スタックで動作します。ベンチマークの結果、フレーム単位のハルシネーションスコアは全システム中最低となりました。Creatify Agent Proは1.90(2.0を下回った唯一のスコア)、Liteは2.85で、いずれも本番品質の不合格しきい値3.0を下回っています。一方、素のT2Vベースラインはすべて3.65〜3.85、HeyGen V3は4.40でした。
3 ベンチマーク
既存の動画品質ベンチマーク(VBench、VBench-2.0、video-arenaのペア比較リーダーボード)は、素のテキストから動画へのモデルのフレーム単位の忠実度を測定するものです。フックの強さ、ブランドの忠実度、CTAの明確さ、広告効果、ハルシネーションのコスト、制作の完成度など、配信可能かどうかを左右する観点で、出力が広告として機能するかを測定するものはありません。VideoAdAgent Bench v1はそのギャップを埋めるために構築されました。リーダーボード全体、審査データ、再実行スクリプトはベンチマークページで公開しています。
3.1 ブリーフセット
このベンチマークは、課題解決型、ビフォーアフター、製品デモ、推薦動画、ライフスタイルといった主要なパフォーマンス広告のパターンをすべて網羅しています。さらに、複数シーン制作で最も難しい観点(軸となるストーリーテリング、ペルソナの一貫性、ブランドアセットの再利用、構造化されたCTAテキスト、説得の流れの遵守)を狙ったストレステストも含みます。各ブリーフは構造化オブジェクト(製品、意図、フォーマット、制約、入力アセット)で、実在顧客の知的財産や個人情報を避けるため、架空のブランドとAI生成の製品モックを使用しています。ブリーフセット全体は、いずれのシステムも出力を生成する前にタグ付きコミットとして事前登録されているため、特定のブリーフに合わせてシステムを調整することはできません。
3.2 評価プロトコル
このベンチマークでは、互いに独立した3つの問いを、3つの独立したペア比較審査アームで検証します。すべてのペアは、画像認識対応の2つのLLM審査員(Claude Opus 4.7+GPT-5)が、左右の位置バイアスを抑えるために配置を入れ替えて2回ずつ審査します。判定は、審査員が入れ替え前後で同じ結論を出した場合にのみ有効とし、合意判定には両審査員の一致が必要です。
| アーム | 問い | ペア | 主要指標 |
|---|---|---|---|
| アーム1 — 能力 | 他のエージェント型動画システムより優れているか? | Creatify対すべての汎用動画エージェント(HeyGen V3、Luma)。審査員はブリーフを確認します。 | エージェント型システムに対する勝率。 |
| 評価軸2 — 広告品質 | 最強クラスの素のT2Vモデルより優れているか? | Creatify対Veo 3.1、Kling 3.0、Seedance 2.0。各モデルにつき2つのベースライン構成を用意:シングルシーン(標準のAPI呼び出し — 1つのプロンプトで8〜12秒のクリップ1本)とマルチシーン(シーンごとに計画したプロンプトをつなぎ合わせたもの)。審査員はブリーフを確認し、広告品質の8項目を評価します。主要な表ではマルチシーン構成の結果を掲載しています。 | 総合選好度(0〜1)。 |
| アーム3 — 動画制作品質 | ブリーフを考慮せずとも、成果物としての品質が高いか? | アーム2と同じペアですが、審査員はブリーフを確認しません。フレーム単位のハルシネーション評価基準を、構造面の遵守に対して3倍の重みで組み込んでいます。 | 動画品質スコア(0〜1)。 |
リーダーボードに掲載する総合スコアは、アーム2(広告品質)とアーム3(制作品質)を組み合わせたもので、上位に入るには両方の観点で高い成績が求められます。フレーム単位のハルシネーションスコア(0〜10、低いほど良好。3.0以上は本番品質として不合格)はアーム3に組み込まれ、リーダーボードでは個別の列としても公開しています。
4 結果
総合スコアでCreatify Agentは全システム中1位となり、本番提供中の両バリアントが、すべての集計指標であらゆる汎用動画エージェントと素のT2Vベースラインを上回りました。Creatifyを含むすべてのシステムは、1つのブリーフを入力し、1本の広告を出力し、フィードバックのやり取りなしという一発生成の条件で評価されています。本番環境のCreatify Agentは対話型で、シーン単位のピンポイントな修正にも対応していますが、一発生成型モデルとの公平な比較のため、ベンチマークではあえてその機能を除外しています。つまり、実際の利用体験はここで報告する数値を上回ります。
| 順位 | システム | 総合 | アーム1 | アーム2 | アーム3 | ハルシネーション ↓ |
|---|---|---|---|---|---|---|
| 1 | Creatify Agent · Pro | 0.901 | 0.732 | 0.775 | 0.855 | 1.90 |
| 2 | Creatify Agent · Lite | 0.836 | 0.716 | 0.757 | 0.778 | 2.85 |
| 3 | Luma Agent | 0.585 | 0.580 | 0.603 | 0.741 | 3.20 |
| 4 | HeyGen V3 Agent | 0.327 | 0.358 | 0.378 | 0.609 | 4.40 |
| 5 | Seedance 2.0(マルチシーン) | 0.312 | — | 0.337 | 0.588 | 3.65 |
| 6 | Kling 3.0(マルチシーン) | 0.301 | — | 0.365 | 0.585 | 3.80 |
| 7 | Veo 3.1(マルチシーン) | 0.287 | — | 0.362 | 0.549 | 3.85 |
5 ケーススタディ
同じプロンプトを使い、実際の本番アプリから得た3つの出力を、最も強力な商用代替手段(基盤T2Vモデル1つ、汎用動画エージェント1つ)と比較しました。本レポートのために厳選したものではありません。各事例はそれぞれ異なるエージェント機能(ブリーフの分解、ブランドアセットへのグラウンディング、Webリサーチ)を示しており、いずれもシングルショットでは実現できないものです。
5.1 マルチショットの料理広告
20秒のTikTok料理広告。約0.4秒ずつ、約50カットで構成。Veo 3.1(シングルショットT2V)およびHeyGen V3(汎用動画エージェント)と比較。
プロンプト"make a super fast paced, .4 second multi shot cooking video making chicken pesto pasta. full video is 20 seconds"
プロデューサーはプロンプトをショットリストとして解析し、約50カットに分解してシーンごとのディレクターへ並列に割り振り、カットのテンポに合わせて音楽を付けます。Veo 3.1のAPIには総尺やマルチショット構成を指定するパラメータがありません(1回の呼び出しの最大尺は8秒、出力は1テイク)。HeyGen V3はプロンプトをショット指定ではなく、アバターが話すナレーション内容として解釈します。
5.2 ブランド画像を軸にしたInstagram広告
ユーザーがTopStepのブランド参照画像をアップロードし、山頂を目指すハイカーのInstagram広告を依頼。Veo 3.1の画像から動画(ブランド画像を開始フレームとして使用)およびHeyGen V3(プロンプトのみ、画像入力なし)と比較。
プロンプト"Create an Instagram carousel ad set for TopStep @input:image-1 using the reference image and inserting a hiker making his way up to mountain with the goal of getting to the top of the mountain"
参照画像は型付きアセットグラフに取り込まれ、すべてのシーンの基盤となります。ブランドカラーは一貫して保たれ、ブランドマークはエンドカードで検証済みのタイポグラフィレイヤーとしてレンダリングされ、ハイカーのキャラクターは導入→苦闘→登頂というストーリー全体を通じて維持されます。Veo 3.1は8秒の1テイク内では開始フレームを保持しますが、複数シーンにわたるストーリーを表現する仕組みがありません。HeyGen V3のAPIはプロンプト文字列しか受け付けないため、ブランド画像は使用されません。
5.3 URLのみのブリーフ(アセットのアップロードなし)
ユーザーはURLを1つ貼り付けるだけ。エージェントがサイトを取得してブランドアイデンティティを抽出し、自らブリーフを作成します。どちらのベースラインもWebにアクセスできません。
プロンプト"Create a vertical TikTok video ad for https://omakai.com/"
OMAKAIはマイアミにあるおまかせ寿司レストランです。プロデューサーのWeb取得ステップがomakai.comを取得し、ブランド名、おまかせというコンセプト、マイアミでのポジショニングを抽出したうえで、生成を呼び出す前にストーリーボードをその情報に基づいて構成します。どちらのベースラインもWeb取得機能を持ちません。Veo 3.1はプロンプト文字列から、映像としては十分な品質ながら内容は汎用的なレストラン映像を生成し、HeyGen V3はURLそのものをナレーションとして読み上げます。URLのみのブリーフは、本番アプリにおけるSMBのオンボーディングで最も多いケースです。
6 制限事項
ハルシネーションは少ないが、ゼロではない。 Creatifyの両バリアントは本番品質のハルシネーション基準をクリアしています(Proは1.90、Liteは2.85)が、Proで生成された広告のごく一部には、クリティックが見逃した軽微なブランドテキストの揺れや、カット間の微妙な不整合が残っています。この残存をゼロに近づけることは、現在取り組んでいる研究テーマです。
ワンショット評価のみ。 本ベンチマークは、1つのブリーフを入力して1つの広告を出力する形式で、フィードバックのやり取りなしに評価しています。本番のエージェントは対話型で、ユーザーが残った不具合を指摘すると(「シーン3の価格が間違っている」など)、修正内容を反映したシーン単位のピンポイントな再生成が行われます。対話的なフィードバックによって達成できるハルシネーション率は、ここで報告するワンショットの数値より大幅に低くなりますが、本レポートでは検証していません。
7 再現性
本レポートのすべての主張は、今回のローンチに合わせてgithub.com/creatify-ai/VABenchでオープンソースとして公開したベンチマークで再現できます。ブリーフセット、スキーマ、ジャッジ用プロンプト、採点ルーブリック、ランナーのスキャフォールド、集計スクリプトがすべて含まれています。ブリーフセットは、いずれのシステムも出力を生成する前にタグ付きコミットとして事前登録されているため、ベンチマーク内のどのシステムも特定のブリーフに合わせてチューニングすることはできませんでした。
8 関連研究
- マルチエージェント動画生成:Mora、VideoDirectorGPT、FilmAgent、StoryAgent、VISTA。
- 動画品質ベンチマーク: VBench / VBench-2.0、VideoGen-Eval、ペア比較での位置バイアスを抑えるためのArtificial Analysis Video Arena。
- 動画向け報酬モデリング:VideoReward / Flow-DPO、UnifiedReward。
- 広告特化型の評価基準: Springboards Creativity Benchmark、AdsQA、Pitt Ads Dataset、冒頭3秒の評価には「Decoding the Hook」。
- クローズドループ型の品質保証: Meta-Harness(Lee、Khattab、Finnら)、明示的なポリシーに基づく批評・修正ループを扱うLearning Beyond Gradients(Weng)。