
Creatify Agent: ein Closed-Loop-Multi-Agenten-System für Video- und Bildanzeigen-Creatives
Von Creatify Research · 2026-05-15
Zusammenfassung
Creatify Agent ist ein Closed-Loop-Multi-Agenten-System, das speziell für Video- und Bildwerbung entwickelt wurde. Aus einem einzigen Kreativ-Briefing – oft nur eine Produkt-URL oder eine Markenreferenz – plant der Agent den Spot, verteilt jede Szene an ein Generierungs-Backend, das er pro Einstellung auswählt, vertont das Ganze, setzt die Typografie und prüft das Ergebnis gegen das Briefing, bevor er eine fertige, markentreue Anzeige ausliefert. Dieselbe Closed-Loop-Architektur erzeugt auch Bild-Creatives: Sie plant die Komposition, wählt pro Asset ein Generierungs-Backend und prüft das Ergebnis gegen das Briefing. Das System unterscheidet sich strukturell von den beiden benachbarten Tool-Klassen, mit denen es am häufigsten verglichen wird: einem Text-to-Video-Foundation-Model, das aus einem Prompt einen einzelnen kurzen Clip erzeugt, und einem universellen Video-Agenten, der ein einzelnes Modell hinter einer Chat-Oberfläche verpackt. Dieser Bericht beschreibt die Architektur, stellt VideoAdAgent Bench v1 vor – den ersten öffentlichen Benchmark für die KI-Produktion von Videoanzeigen – und berichtet das zentrale Ergebnis: Creatify Agent übertrifft universelle Video-Agenten und führende Text-to-Video-Modelle bei den Gesamt-, Halluzinations- und paarweisen Präferenzmetriken, die darüber entscheiden, ob eine fertige Anzeige veröffentlichungsreif ist.
0.901
Gesamtqualität · Creatify Agent Pro
Platz eins im Feld. Der Lite-Modus folgt mit 0.836; das stärkste Nicht-Creatify-System liegt bei 0.585.
95%
Paarweise Gewinnquote gegenüber reinem Text-to-Video
Anteil des Pro-Modus an den paarweisen Konsensurteilen gegen die stärksten reinen T2V-Baselines. 87 % gegen universelle Video-Agenten.
1.90
Halluzinations-Score · Creatify Agent Pro
Kriterienkatalog auf Frame-Ebene, 0–10 (niedriger ist besser). Das einzige System im Feld unter 2.0; beide Creatify-Varianten liegen unter der FAIL-Schwelle für Produktionsreife von 3.0 (Lite bei 2.85).
1 Einleitung
Ein Performance-Anzeigen-Creative – ob Video oder Bild – unterscheidet sich strukturell von dem, was ein führendes generatives Modell ausgibt. Eine Videoanzeige ist ein Deliverable von 15 bis 60 Sekunden mit mehreren Einstellungen: Hook, Hauptteil, Produktmoment, abgestimmtem Ton, markenkonformer Typografie und Call-to-Action. Ein T2V-Foundation-Model – Veo 3.1, Kling 3.0, Seedance 2.0, Sora 2 – rendert eine einzelne Einstellung in hoher visueller Qualität, kennt aber keinen Plan über mehrere Szenen, prüft den Markenzustand nicht über Schnitte hinweg, stimmt keinen Ton auf den Schnittrhythmus ab und hat keine Typografie-Ebene. Ein universeller Video-Agent verpackt ein solches Modell hinter einer Chat-Oberfläche, erbt aber dieselbe Lücke: Er fügt eine Chat-Oberfläche hinzu, nicht die auf Anzeigen spezialisierte Prüfebene, die darüber entscheidet, ob eine fertige Anzeige veröffentlichungsreif ist.
Creatify Agent gehört zu keiner dieser beiden Klassen. Er ist eine Orchestrierungsebene, die Marke und Briefing als Input nimmt und die Arbeit auf genau die Generierungsmodelle, Retrieval-Schritte, Audiodienste und Prüfdurchgänge verteilt, die das Briefing erfordert. Er wählt Modelle pro Szene aus, statt selbst eines zu sein. Er führt einen typisierten Zustand – Markenfarben, Produktfakten, Persona-Identität, Pflichttexte im Bild – durch die gesamte Produktion und prüft jede Szene vor der Auslieferung gegen diesen Zustand, statt dem ersten Output des Generators zu vertrauen. Die jüngere Forschung zu Agentensystemen (Mora, VISTA, VideoReward) kommt übereinstimmend zu dem Schluss, dass eine Multi-Agenten-Zerlegung mit einem Kritiker im Loop die Generierung mit einem einzelnen Modell in jeder Dimension übertrifft, die über ein fertiges Deliverable entscheidet; Creatify Agent setzt diesen Ansatz durchgängig für Werbung um und wird auf dem in §3 vorgestellten Benchmark mit dem restlichen Feld verglichen.
2 Systemdesign
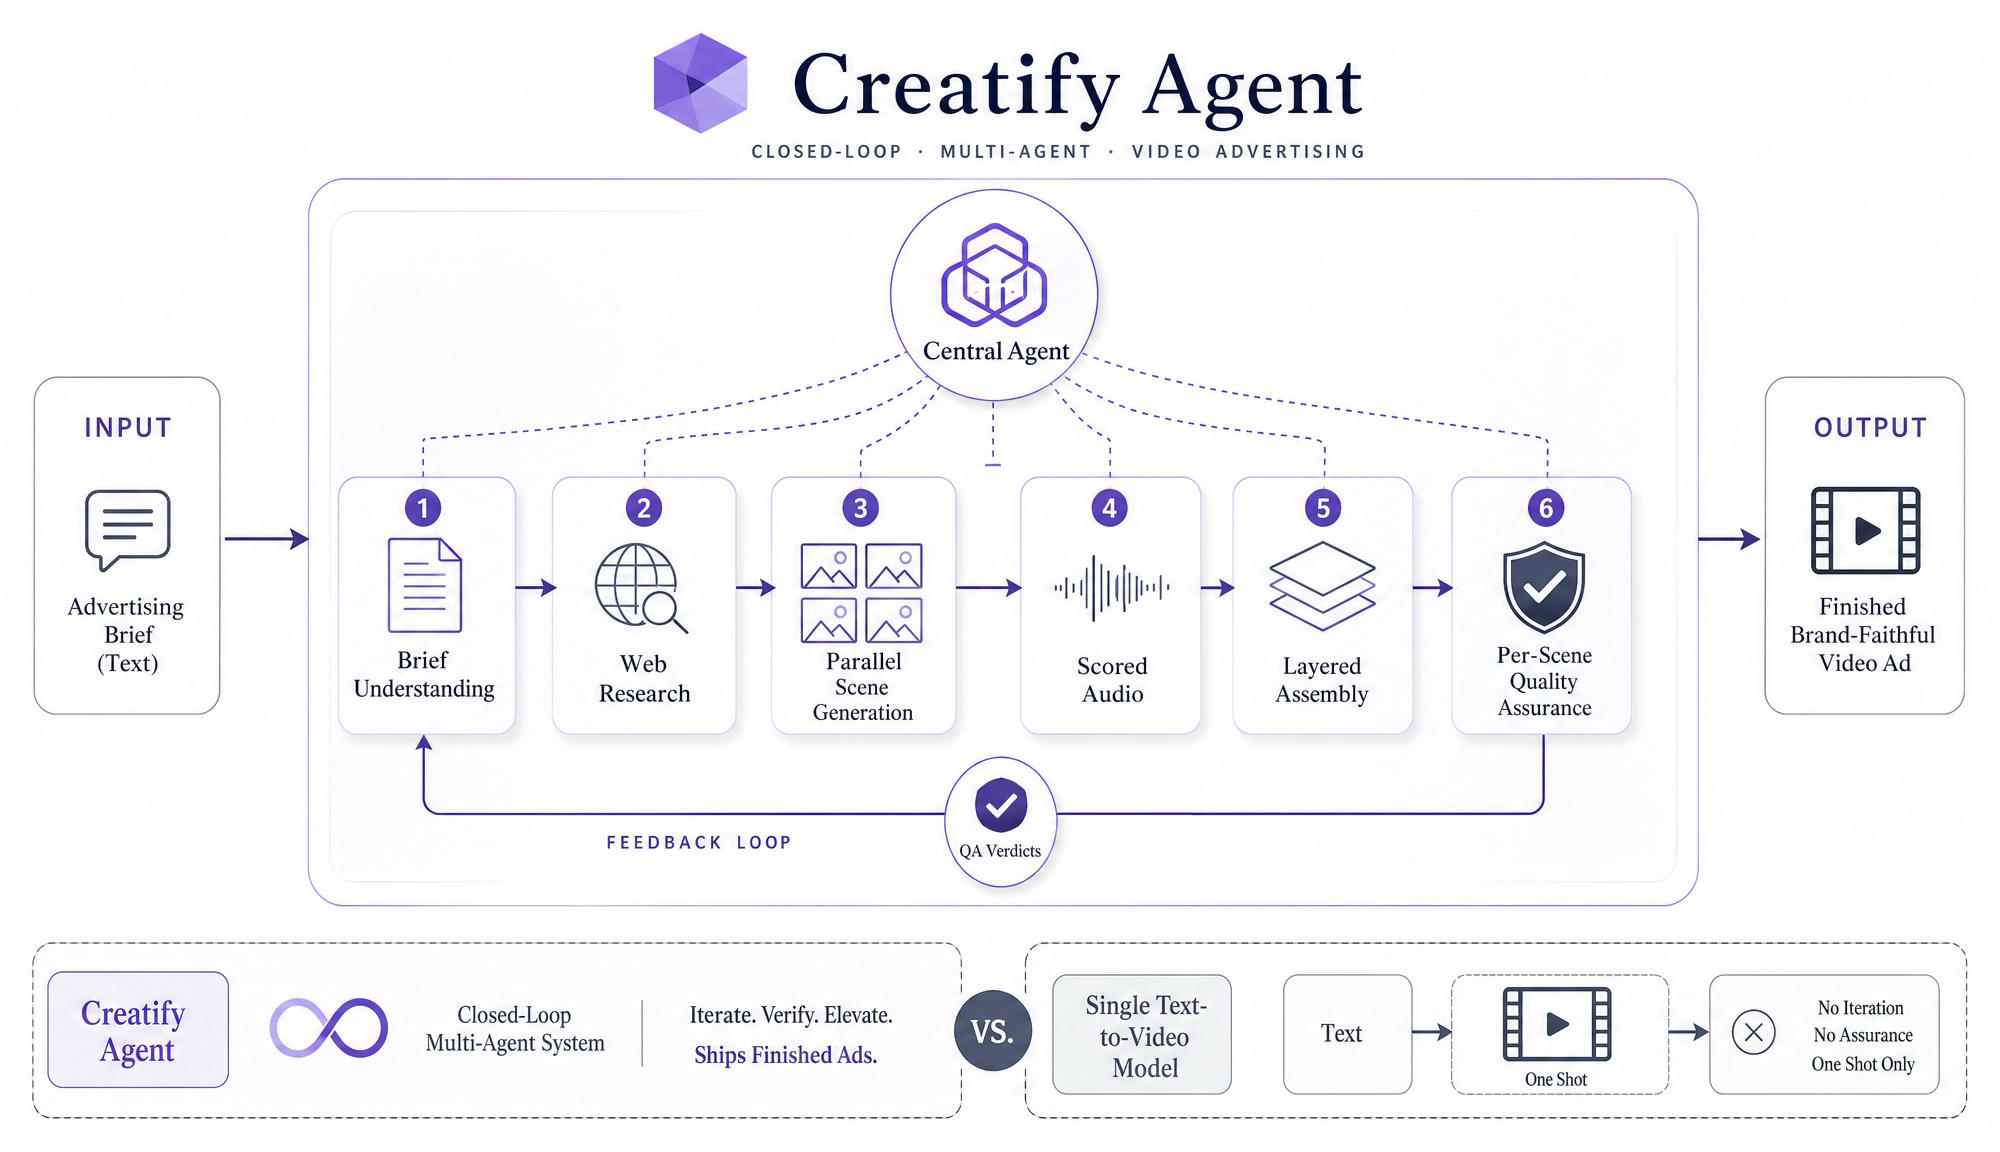
Unser Agent arbeitet als geschlossener Kreislauf spezialisierter Sub-Agenten. Ein Producer nimmt das Briefing auf, leitet einen Szenenplan ab und erzeugt einen typisierten Asset-Graphen: Produktfakten, Persona-Beschreibungen, Markenzustand, Pflichttexte im Bild. Directors übersetzen Szenenspezifikationen in Generierungsaufrufe und wählen Modelle und Parameter pro Einstellung. Ein Kritiker bewertet jede gerenderte Szene anhand eines expliziten Kriterienkatalogs gegen den Asset-Graphen und gibt sie entweder frei oder mit einem strukturierten Urteil an den Director zurück – so wird eine Szene, die bei der Treue scheitert, lokal neu generiert, statt die gesamte Anzeige neu zu würfeln. Der Kreislauf schließt sich nach der Auslieferung: Jede veröffentlichte Anzeige wird bewertet, jeder Fehler wird zum Regressionsfall, und der Kriterienkatalog wird mit jeder Produktion strenger.
2.1 Kreativrecherche und referenzbasierte Generierung
Der Producer kann ein Briefing in echtem kreativem Kontext verankern, bevor überhaupt eine Szene gerendert wird. Nutzer können den Agenten eine Creative-Suche ausführen lassen – er ruft auf TikTok und Instagram 8–10 leistungsstarke Anzeigen aus der Kategorie der Marke ab, inklusive Engagement-Metadaten und Hook-Analyse – und die gefundenen Formate anschließend als Referenz-Input für das Storyboard nutzen. Herauszufinden, was in der Kategorie funktioniert, wird so zu einem vollwertigen Schritt, den man anfordern kann, statt zu einem separaten Rechercheprojekt. Zwei weitere Modalitäten verankern das Briefing auf dieselbe Weise. Eine URL (zum Beispiel omakai.com) wird abgerufen und nach der Markenidentität ausgewertet – Name, Konzept, Farbpalette, Hero-Bilder –, sodass auch Nutzer ohne hochgeladene Asset-Bibliothek einen markentreuen Spot erhalten. Ein Referenzvideo – ein viraler TikTok, ein Spot der Konkurrenz, ein bestehendes Marken-Reel – wird in seine wirksamen Bestandteile zerlegt (Schnittrhythmus, Farbe und Licht, Bildsprache, Übergangsstil, Rhythmus der Texteinblendungen), die dann den Szenenplan verankern. Keine dieser Modalitäten steht einem T2V-Foundation-Model oder einem universellen Video-Agenten zur Verfügung: Für sie ist eine URL nur eine Zeichenkette, Referenzvideos werden nicht unterstützt, und aktueller kreativer Kontext liegt außerhalb ihres Trainingsstichtags.
2.2 Dauerhaftes Markengedächtnis
Der Agent führt ein strukturiertes Gedächtnis über Sitzungen hinweg, getrennt nach Nutzer und Marke. Produktfakten (Preispunkte, Hero-Features, Dinge, die nicht gezeigt werden dürfen), Markenstimme und Farbpalette, Persona-Präferenzen und erfolgreiche frühere kreative Richtungen werden automatisch gespeichert; ein Destillationsschritt am Ende jeder Sitzung schlägt dauerhafte Fakten vor, die es wert sind, behalten zu werden. Wenn ein Nutzer zum zweiten Mal eine Anzeige für dieselbe Marke anfordert, muss er weder das Brand Kit erneut hochladen noch den Preispunkt erneut erklären oder die Stimme neu auswählen. Jedes Text-to-Video-Modell und jeder universelle Video-Agent, den wir getestet haben, beginnt bei jedem Aufruf bei null.
2.3 Modulare Skills und Erweiterung auf mehrere Outputs
Produktions-Skills sind modular. Ein einziger Producer kann aus demselben Briefing-Format einen creator-geführten UGC-Spot, eine hochwertige Produktdemo, ein persona-basiertes Testimonial (auf Basis von Aurora, Creatifys hauseigenem Avatar-Modell), ein Motion-Design-Reel mit kinetischer Typografie oder eine auf Wettbewerbsrecherche gestützte Vergleichsanzeige liefern. Der strukturierte Asset-Graph erlaubt außerdem, aus einem einzigen Briefing mit geringen Grenzkosten mehrere Outputs abzuleiten – alternative Hooks, alternative Personas, alternative Seitenverhältnisse –, ohne die gesamte Produktion neu zu würfeln, da sich einzelne Achsen unabhängig voneinander verändern lassen.
2.4 Vertonung
Audio wird als vollwertiges Produktionselement generiert und getimt, statt nachträglich hinzugemischt zu werden. Ein Musiktrack wird passend zum Schnittrhythmus generiert; das Voiceover wird separat über eine TTS-Ebene mit markengerechter Tonalität und passendem Tempo gerendert; beides wird mit bekannten Offsets über die Video- und Typografie-Ebenen gelegt. Jede Creatify-Variante im Benchmark wird mit abgestimmtem Ton ausgeliefert; jede reine Text-to-Video-Baseline ist stumm; HeyGen V3 liefert nur Avatar-Sprache. Die Audioqualität ist eine der Dimensionen, die die Juroren in Zweig 3 (ohne Briefing) am stärksten gewichten – das erklärt zum Teil die klare Trennung in Zweig 3.
2.5 Halluzinationskontrolle im Loop
Der Kritiker ist ein Modell mit Vision-Fähigkeiten, das innerhalb des Produktionskreislaufs läuft – kein nachgelagerter Filter. Jede Szene wird anhand eines expliziten Kriterienkatalogs gegen den typisierten Asset-Graphen bewertet – Produkttreue, Objekt-Halluzinationen, Textqualität, physikalische Verstöße, Anatomie, Gesamtqualität –, und Fehler werden mit einem strukturierten Urteil (welche Dimension, wie stark, in welchem Frame) zur Neugenerierung zurückgeleitet, wobei dieses Feedback direkt einfließt. Kriterienkatalog und Schwellenwerte sind für Menschen lesbare Regeln, die das Team verschärfen kann, keine undurchsichtigen Modellgewichte – eine Designentscheidung, die in jüngerer Forschung zu Agentensystemen formuliert wurde, etwa zum Harness als Optimierungsziel (Lee, Khattab, Finn et al.) und zu Kritik-und-Überarbeitungs-Schleifen über explizite Richtlinien (Weng). Der Kritiker läuft auf einem hauseigenen Vision-Stack, der auf typische Fehler von Anzeigen spezialisiert ist – abdriftende Markenzeichen, falsch dargestellte Produktetiketten, verstümmelte CTAs, Kontinuitätsbrüche über Schnitte hinweg. Das Benchmark-Ergebnis ist der niedrigste Halluzinations-Score auf Frame-Ebene im Feld: Creatify Agent Pro mit 1.90 (der einzige Score unter 2.0), Lite mit 2.85, beide unter der FAIL-Schwelle für Produktionsreife von 3.0; alle reinen T2V-Baselines erreichen 3.65–3.85, HeyGen V3 kommt auf 4.40.
3 Benchmark
Bestehende Benchmarks für Videoqualität (VBench, VBench-2.0, paarweise Video-Arena-Leaderboards) messen die Bildtreue einzelner Frames bei reinen Text-to-Video-Modellen; keiner misst, ob das Ergebnis als Anzeige funktioniert – entlang der Achsen, die über die Veröffentlichungsreife entscheiden: Stärke des Hooks, Markentreue, Klarheit des CTA, Anzeigenwirkung, Kosten von Halluzinationen, Produktionsfeinschliff. VideoAdAgent Bench v1 wurde entwickelt, um diese Lücke zu schließen; das vollständige Leaderboard, die Bewertungsartefakte und Skripte zum erneuten Ausführen sind auf der Benchmark-Seite öffentlich verfügbar.
3.1 Briefing-Set
Der Benchmark deckt alle wichtigen Muster von Performance-Anzeigen ab – Problem-Lösung, Vorher-Nachher, Produktdemo, Testimonial, Lifestyle – plus Stresstests für die schwierigsten Achsen der Multi-Scene-Produktion (Anker-Storytelling, Persona-Konsistenz, Wiederverwendung von Marken-Assets, strukturierter CTA-Text, Einhaltung des Überzeugungsbogens). Jedes Briefing ist ein strukturiertes Objekt (Produkt, Absicht, Format, Vorgaben, Input-Assets) und verwendet fiktive Marken und KI-generierte Produkt-Mockups, um geistiges Eigentum und personenbezogene Daten echter Kunden zu vermeiden. Das gesamte Set wird in einem getaggten Commit vorregistriert, bevor ein System Output erzeugt – so kann kein System auf die konkreten Briefings abgestimmt werden.
3.2 Evaluierungsprotokoll
Der Benchmark trennt drei voneinander unabhängige Fragen in drei unabhängige Zweige mit paarweiser Bewertung. Jede Paarung wird von zwei LLM-Juroren mit Vision-Fähigkeiten (Claude Opus 4.7 + GPT-5) zweimal mit vertauschten Positionen bewertet, um eine Links-rechts-Verzerrung auszuschließen; ein Urteil zählt nur, wenn ein Juror über den Tausch hinweg bei seinem Urteil bleibt, und für ein Konsensurteil müssen beide Juroren übereinstimmen.
| Zweig | Frage | Paarungen | Zentrale Kennzahl |
|---|---|---|---|
| Zweig 1 — Leistungsfähigkeit | Ist der Agent besser als andere agentische Videosysteme? | Creatify vs. jeden universellen Video-Agenten (HeyGen V3, Luma). Die Juroren sehen das Briefing. | Gewinnquote gegen das agentische Feld. |
| Zweig 2 — Anzeigenqualität | Ist der Agent besser als die stärksten reinen T2V-Modelle? | Creatify vs. Veo 3.1, Kling 3.0, Seedance 2.0. Zwei Baseline-Konfigurationen pro Modell: Single-Scene (Standard-API-Aufruf – ein Prompt, ein Clip von 8–12 s) und Multi-Scene (geplante Prompts pro Szene, aneinandergefügt). Die Juroren sehen das Briefing und bewerten acht Dimensionen der Anzeigenqualität; die Übersichtstabelle zeigt die Multi-Scene-Konfiguration. | Gesamtpräferenz (0–1). |
| Zweig 3 — Videoproduktionsqualität | Ist das Ergebnis – unabhängig vom Briefing – ein hochwertigeres Deliverable? | Dieselben Paarungen wie in Zweig 2, aber die Juroren sehen das Briefing nicht. Ein Halluzinations-Kriterienkatalog auf Frame-Ebene fließt mit 3-facher Gewichtung gegenüber der strukturellen Konformität ein. | Videoqualitäts-Score (0–1). |
Der im Leaderboard angegebene Gesamtwert kombiniert Zweig 2 (Anzeigenqualität) und Zweig 3 (Produktionsqualität) – ein System muss also auf beiden Achsen überzeugen, um aufzusteigen. Ein Halluzinations-Score auf Frame-Ebene (0–10, niedriger ist besser; ≥ 3.0 gilt als FAIL für Produktionsreife) fließt in Zweig 3 ein und wird als eigene Spalte im Leaderboard veröffentlicht.
4 Ergebnisse
Im Gesamtwert liegt Creatify Agent auf Platz eins im Feld; beide produktiv eingesetzten Varianten übertreffen jeden universellen Video-Agenten und jede reine T2V-Baseline in jeder aggregierten Kennzahl. Alle Systeme – Creatify und alle Konkurrenten – werden unter One-Shot-Bedingungen bewertet: ein Briefing rein, eine Anzeige raus, keine Feedbackrunde. Im Produktiveinsatz arbeitet Creatify Agent dialogbasiert und unterstützt gezielte Überarbeitungen einzelner Szenen; der Benchmark verzichtet bewusst auf diese Fähigkeit, um den Vergleich mit One-Shot-Modellen fair zu halten – die Erfahrung im Produktiveinsatz übertrifft also die hier berichteten Zahlen.
| Rang | System | Gesamtwert | Zweig 1 | Zweig 2 | Zweig 3 | Halluzination ↓ |
|---|---|---|---|---|---|---|
| 1 | Creatify Agent · Pro | 0.901 | 0.732 | 0.775 | 0.855 | 1.90 |
| 2 | Creatify Agent · Lite | 0.836 | 0.716 | 0.757 | 0.778 | 2.85 |
| 3 | Luma Agent | 0.585 | 0.580 | 0.603 | 0.741 | 3.20 |
| 4 | HeyGen V3 Agent | 0.327 | 0.358 | 0.378 | 0.609 | 4.40 |
| 5 | Seedance 2.0 (Multi-Scene) | 0.312 | — | 0.337 | 0.588 | 3.65 |
| 6 | Kling 3.0 (Multi-Scene) | 0.301 | — | 0.365 | 0.585 | 3.80 |
| 7 | Veo 3.1 (Multi-Scene) | 0.287 | — | 0.362 | 0.549 | 3.85 |
5 Fallstudien
Drei echte Outputs aus der Produktiv-App, mit demselben Prompt gegen die stärksten kommerziellen Alternativen erzeugt (ein T2V-Foundation-Model, ein universeller Video-Agent). Nicht für den Bericht ausgewählt. Jeder Fall zeigt eine andere Fähigkeit des Agenten – Zerlegung des Briefings, Verankerung in Marken-Assets, Webrecherche –, für die es kein One-Shot-Gegenstück gibt.
5.1 Kochanzeige mit vielen Einstellungen
20-sekündige TikTok-Kochanzeige mit ~50 Schnitten à ~0.4 s. Verglichen mit Veo 3.1 (One-Shot-T2V) und HeyGen V3 (universeller Video-Agent).
Prompt"make a super fast paced, .4 second multi shot cooking video making chicken pesto pasta. full video is 20 seconds"
Der Producer liest den Prompt als Shotlist, zerlegt ihn in ~50 Schnitte, die parallel an Directors pro Szene verteilt werden, und stimmt den Ton auf den Schnittrhythmus ab. Die API von Veo 3.1 hat keinen Parameter für Gesamtdauer oder eine Struktur mit mehreren Einstellungen (maximale Dauer pro Aufruf 8 s, Ausgabe eine Einstellung). HeyGen V3 interpretiert den Prompt als Sprechtext für seinen Avatar statt als Shot-Spezifikation.
5.2 Instagram-Anzeige auf Basis eines Markenbilds
Ein Nutzer lädt ein Referenzbild der Marke TopStep hoch und wünscht sich eine Instagram-Anzeige mit einem Wanderer auf dem Weg zum Gipfel. Verglichen mit Veo 3.1 Image-to-Video (Markenbild als Startframe) und HeyGen V3 (nur Prompt – kein Bild-Input).
Prompt"Create an Instagram carousel ad set for TopStep @input:image-1 using the reference image and inserting a hiker making his way up to mountain with the goal of getting to the top of the mountain"
Das Referenzbild wird in den typisierten Asset-Graphen aufgenommen und verankert jede Szene: Die Markenfarben bleiben erhalten, das Markenzeichen wird als geprüfte Typografie-Ebene auf der Endkarte dargestellt, und der Wanderer bleibt über den Bogen Aufbruch→Anstrengung→Gipfel hinweg derselbe. Veo 3.1 erhält den Startframe innerhalb einer 8-Sekunden-Einstellung, kann aber keinen Bogen über mehrere Szenen abbilden. Die API von HeyGen V3 akzeptiert nur einen Prompt-String, daher wird das Markenbild nicht verwendet.
5.3 Briefing nur per URL, ohne hochgeladene Assets
Der Nutzer fügt eine einzige URL ein; der Agent ruft die Website ab, extrahiert die Markenidentität und schreibt sein eigenes Briefing. Keine der Baselines kann auf das Web zugreifen.
Prompt"Create a vertical TikTok video ad for https://omakai.com/"
OMAKAI ist ein Omakase-Sushi-Restaurant in Miami. Der Webrecherche-Schritt des Producers ruft omakai.com ab, extrahiert Markennamen, Omakase-Konzept und Miami-Positionierung und verankert damit das Storyboard, bevor überhaupt ein Generierungsaufruf erfolgt. Keine der Baselines verfügt über Webrecherche: Veo 3.1 erzeugt aus dem Prompt-String visuell solide, inhaltlich aber generische Restaurantaufnahmen; HeyGen V3 liest die URL selbst als Sprechtext vor. Briefings nur per URL sind in der Produktiv-App der häufigste Onboarding-Fall bei KMU.
6 Einschränkungen
Halluzinationen sind selten, aber nicht null. Beide Creatify-Varianten liegen unter der Halluzinationsschwelle für Produktionsreife (Pro bei 1.90, Lite bei 2.85), doch ein kleiner Teil der im Pro-Modus generierten Anzeigen enthält noch leichte Unsauberkeiten im Markentext oder subtile Inkonsistenzen zwischen Schnitten, die der Kritiker übersehen hat. Diesen Rest gegen null zu bringen, ist ein aktiver Forschungsschwerpunkt.
Nur One-Shot-Evaluierung. Der Benchmark bewertet ein Briefing rein, eine Anzeige raus, ohne Feedbackrunde. Der produktive Agent arbeitet dialogbasiert: Markiert ein Nutzer einen verbleibenden Fehler („der Preis in Szene 3 ist falsch"), löst das eine gezielte Neugenerierung dieser einen Szene mit der eingearbeiteten Korrektur aus. Die durch interaktives Feedback erreichbare Halluzinationsrate liegt deutlich unter dem hier berichteten One-Shot-Wert und wird in diesem Bericht nicht untersucht.
7 Reproduzierbarkeit
Jede Aussage in diesem Bericht lässt sich mit dem öffentlichen Benchmark reproduzieren, der zusammen mit diesem Launch als Open Source unter github.com/creatify-ai/VABench veröffentlicht wurde. Briefing-Set, Schemas, Juroren-Prompts, Bewertungskriterien, Runner-Gerüste und Aggregationsskripte sind enthalten. Das Briefing-Set wurde in einem getaggten Commit vorregistriert, bevor ein System Output erzeugte – so konnte kein System im Benchmark auf die konkreten Briefings abgestimmt werden.
8 Verwandte Arbeiten
- Multi-Agenten-Videogenerierung: Mora, VideoDirectorGPT, FilmAgent, StoryAgent, VISTA.
- Benchmarks für Videoqualität: VBench / VBench-2.0; VideoGen-Eval; Artificial Analysis Video Arena zur Kontrolle von Positionsverzerrungen beim paarweisen Vergleich.
- Reward-Modellierung für Video: VideoReward / Flow-DPO, UnifiedReward.
- Anzeigenspezifische Bewertungskriterien: Springboards Creativity Benchmark, AdsQA, das Pitt Ads Dataset, „Decoding the Hook" zur Bewertung der ersten 3 Sekunden.
- Closed-Loop-Qualitätssicherung: Meta-Harness (Lee, Khattab, Finn et al.); Learning Beyond Gradients (Weng) zu Kritik-und-Überarbeitungs-Schleifen über explizite Richtlinien.