Creatify Agent: um sistema multiagente de ciclo fechado para criativos de anúncios em vídeo e imagem
Por Creatify Research · 2026-05-15
Resumo
O Creatify Agent é um sistema multiagente de ciclo fechado criado especificamente para publicidade em vídeo e imagem. A partir de um único briefing criativo — muitas vezes apenas a URL de um produto ou uma referência de marca —, o agente planeja a peça, envia cada cena a um backend de geração que ele escolhe tomada a tomada, cria a trilha sonora, compõe a tipografia e verifica o resultado em relação ao briefing antes de entregar um anúncio finalizado e fiel à marca. A mesma arquitetura de ciclo fechado produz criativos de imagem, planejando a composição, escolhendo um backend de geração para cada ativo e verificando o resultado em relação ao briefing. O sistema é estruturalmente diferente das duas categorias de ferramenta vizinhas com que mais costuma ser comparado: um modelo fundacional de texto para vídeo, que produz um único clipe curto a partir de um prompt, e um agente de vídeo de uso geral, que envolve um único modelo em uma interface conversacional. Este relatório descreve a arquitetura, apresenta o VideoAdAgent Bench v1 — o primeiro benchmark público para produção de anúncios em vídeo com IA — e relata o principal resultado: o Creatify Agent supera agentes de vídeo de uso geral e os modelos de texto para vídeo mais avançados nas métricas composta, de alucinação e de preferência pareada, que determinam se um anúncio finalizado está pronto para publicação.
0.901
Qualidade composta · Creatify Agent Pro
Primeiro lugar no campo. O modo Lite vem em seguida, com 0.836; o sistema mais forte fora da Creatify fica atrás, com 0.585.
95%
Taxa de vitória pareada contra texto para vídeo puro
Proporção de veredictos pareados de consenso do modo Pro contra as bases T2V puras mais fortes. 87% contra agentes de vídeo de uso geral.
1.90
Pontuação de alucinação · Creatify Agent Pro
Critérios por quadro, 0–10 (quanto menor, melhor). O único sistema do campo abaixo de 2.0; as duas variantes da Creatify ficam abaixo do limite de reprovação de qualidade de produção, 3.0 (Lite com 2.85).
1 Introdução
Um criativo de anúncio de performance — em vídeo ou imagem — é estruturalmente diferente do que um modelo generativo de ponta produz. Um anúncio em vídeo é uma entrega de 15 a 60 segundos com várias tomadas, com gancho, desenvolvimento, momento do produto, trilha sonora, tipografia alinhada à marca e uma chamada para ação. Um modelo T2V fundacional — Veo 3.1, Kling 3.0, Seedance 2.0, Sora 2 — renderiza uma tomada com alta fidelidade visual, sem representação de um plano com várias cenas, sem verificação do estado da marca entre os cortes, sem áudio sincronizado ao ritmo dos cortes e sem camada de tipografia. Um agente de vídeo de uso geral envolve esse tipo de modelo em uma interface conversacional, mas herda a mesma lacuna: ele acrescenta uma interface de chat, não a camada de verificação especializada em anúncios que determina se um anúncio finalizado está pronto para publicação.
O Creatify Agent não pertence a nenhuma dessas categorias. Ele é uma camada de orquestração que recebe uma marca e um briefing como entrada e distribui o trabalho entre os modelos de geração, etapas de recuperação, serviços de áudio e passes de verificação que o briefing exigir. Ele escolhe modelos por cena, em vez de ser um modelo. Ele mantém um estado tipado — cores da marca, fatos do produto, identidade da persona, texto obrigatório na tela — ao longo da produção e verifica cada cena em relação a esse estado antes da entrega, em vez de confiar na primeira saída do gerador. Pesquisas recentes sobre sistemas de agentes (Mora, VISTA, VideoReward) convergiram para a conclusão de que a decomposição multiagente com um crítico no ciclo supera a geração com um único modelo em todas as dimensões que determinam uma entrega finalizada; o Creatify Agent é uma concretização dessa direção, especializada de ponta a ponta para publicidade e avaliada em relação ao restante do campo no benchmark apresentado no §3.
2 Arquitetura do sistema
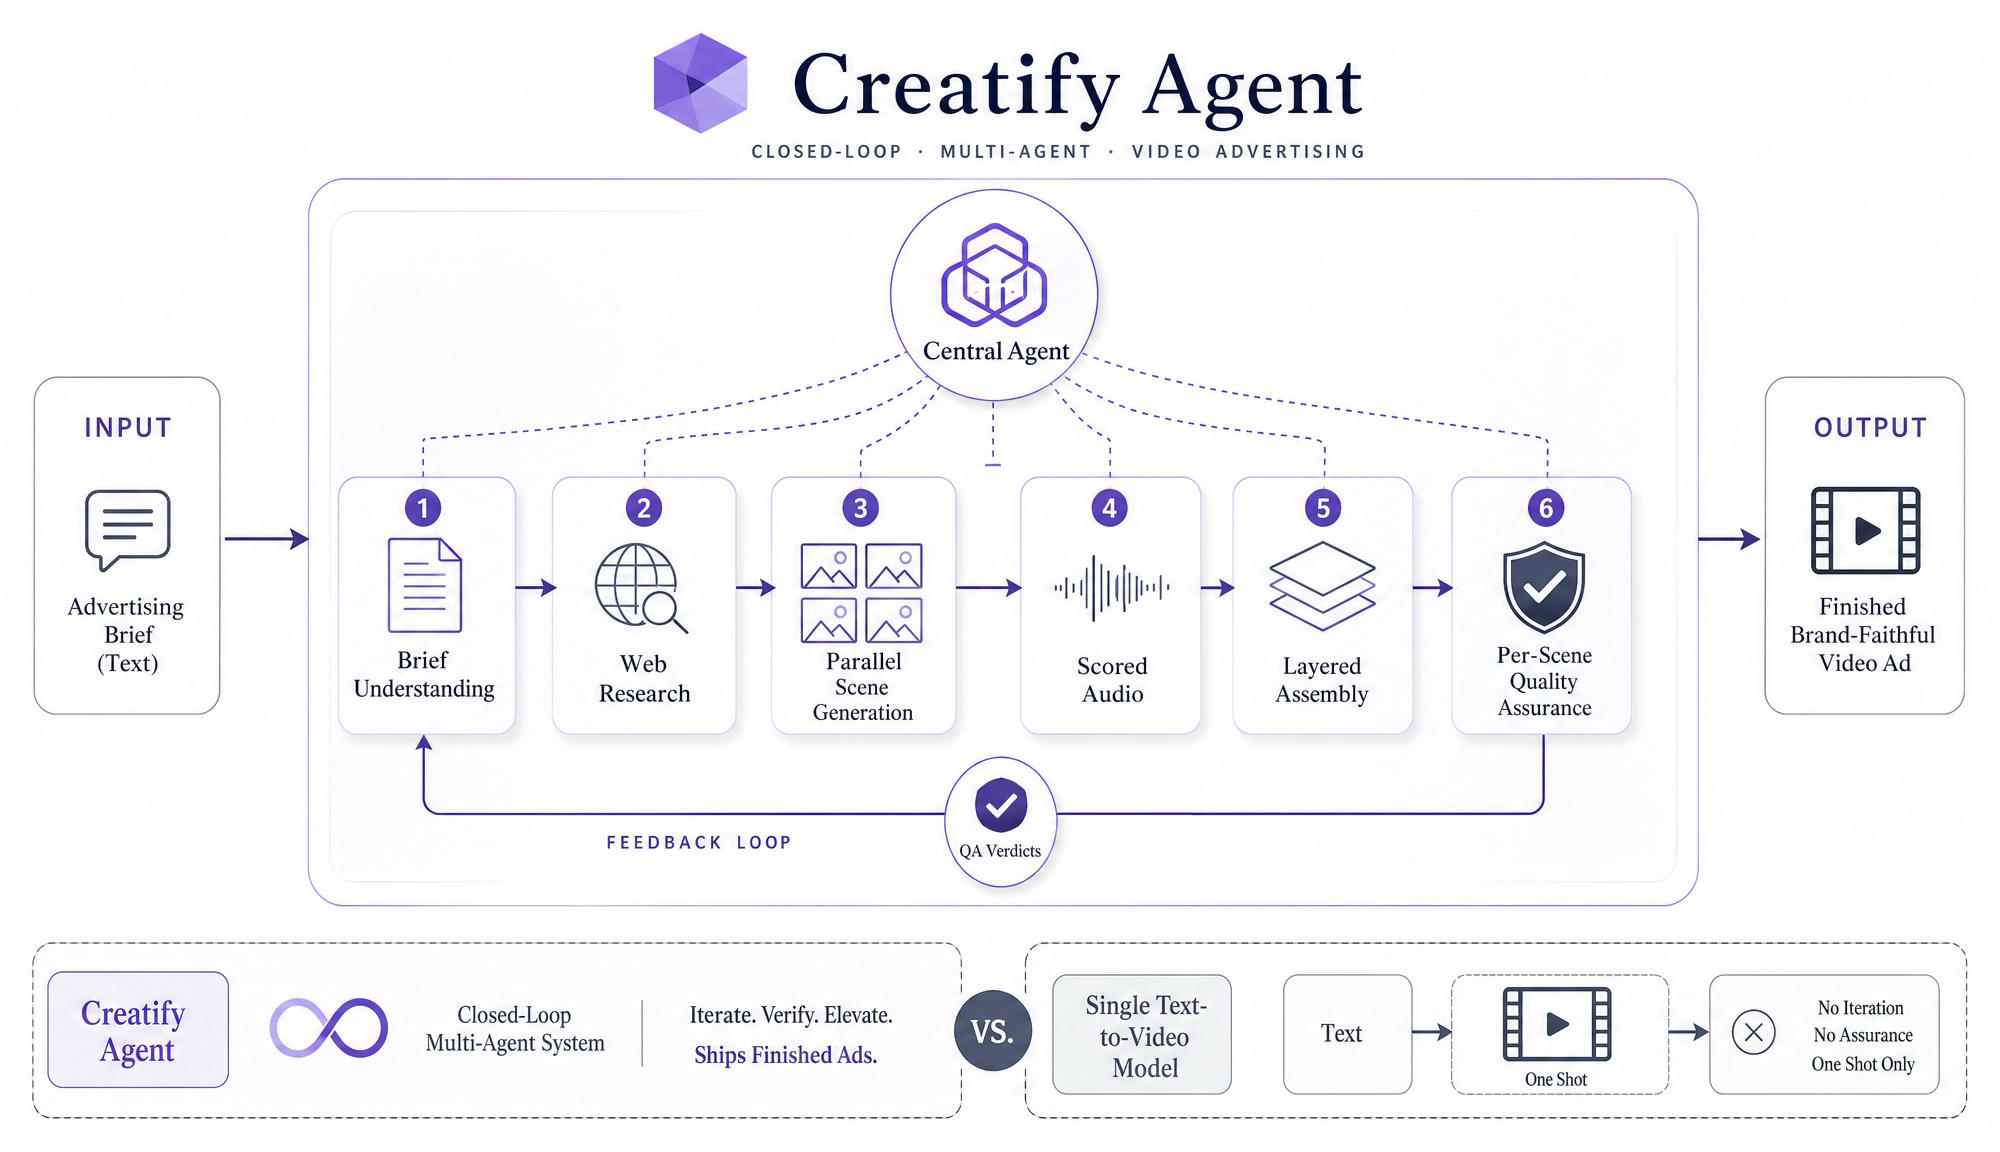
Nosso agente funciona como um ciclo fechado de subagentes especializados. Um produtor recebe o briefing, deriva um plano de cenas e emite um grafo tipado de ativos: fatos do produto, descritores de persona, estado da marca, texto obrigatório na tela. Os diretores traduzem as especificações de cada cena em chamadas de geração, escolhendo modelos e parâmetros por tomada. Um crítico avalia cada cena renderizada em relação ao grafo de ativos, seguindo critérios explícitos, e a aprova ou a devolve ao diretor com um veredicto estruturado, de modo que uma cena que falha em fidelidade é regenerada localmente, em vez de exigir que o anúncio inteiro seja gerado de novo. O ciclo se fecha após a entrega: cada anúncio publicado é avaliado, cada defeito vira um caso de regressão e os critérios ficam mais rigorosos a cada produção.
2.1 Pesquisa criativa e geração ancorada em referências
O produtor pode embasar um briefing em contexto criativo real antes de qualquer cena ser renderizada. O usuário pode pedir ao agente que faça uma pesquisa criativa — consultando o TikTok e o Instagram em busca de 8–10 anúncios de alto desempenho na categoria da marca, retornados com metadados de engajamento e a decomposição dos ganchos — e, depois, usar os formatos encontrados como referência para o storyboard. Assim, identificar o que está funcionando na categoria vira uma etapa nativa que o usuário pode solicitar, e não um projeto de pesquisa à parte. Outras duas modalidades embasam o briefing da mesma forma. Uma URL (por exemplo, omakai.com) é acessada e analisada para extrair a identidade da marca — nome, conceito, paleta, imagens principais —, para que um usuário sem biblioteca de ativos enviada ainda produza uma peça fiel à marca. Um vídeo de referência — um TikTok viral, uma peça de concorrente, um reel de marca existente — é decomposto em seus ingredientes (ritmo das tomadas, cor e iluminação, linguagem de câmera, estilo de transição, cadência do texto na tela), que então embasam o plano de cenas. Nenhuma dessas modalidades está disponível para um modelo T2V fundacional ou para um agente de vídeo de uso geral: para eles, uma URL é só uma sequência de caracteres, vídeos de referência não são suportados e o contexto criativo em alta fica fora do seu corte de treinamento.
2.2 Memória de marca persistente
O agente mantém uma memória estruturada entre sessões, organizada por usuário e por marca. Fatos do produto (faixas de preço, recursos principais, itens que não devem aparecer), tom de voz e paleta de cores da marca, preferências de persona e direções criativas bem-sucedidas do passado são retidos automaticamente; uma etapa de síntese ao fim de cada sessão sugere fatos duradouros que vale a pena guardar. Na segunda vez em que um usuário pede um anúncio para a mesma marca, o agente não exige reenviar o kit da marca, explicar de novo a faixa de preço ou escolher a voz outra vez. Todos os modelos de texto para vídeo e todos os agentes de vídeo de uso geral que avaliamos começam do zero a cada chamada.
2.3 Habilidades plugáveis e expansão para múltiplas saídas
As habilidades de produção são plugáveis. Um único produtor pode entregar uma peça UGC conduzida por criadores, uma demonstração de produto sofisticada, um depoimento ancorado em uma persona (criado com o Aurora, o modelo de avatar próprio da Creatify), um reel de motion design com tipografia cinética ou um anúncio comparativo embasado em pesquisa de concorrentes, a partir do mesmo formato de briefing. O grafo estruturado de ativos também permite expandir um único briefing em várias saídas com baixo custo marginal — ganchos alternativos, personas alternativas, proporções alternativas — sem gerar a produção inteira de novo, já que cada eixo pode ser alterado de forma independente.
2.4 Trilha sonora
O áudio é gerado e sincronizado como um elemento central da produção, e não adicionado no fim como algo secundário. Uma trilha musical é gerada no ritmo dos cortes; a locução é renderizada separadamente por uma camada de TTS, com tom e ritmo adequados à marca; ambas são compostas em posições conhecidas sobre as camadas de vídeo e tipografia. Todas as variantes da Creatify no benchmark saem com trilha sonora; todas as bases de texto para vídeo puras saem sem som; a HeyGen V3 sai apenas com a narração do avatar. A qualidade do áudio é uma das dimensões que os juízes do Eixo 3, sem briefing, pontuam com mais peso, o que explica em parte a clara separação no Eixo 3.
2.5 Controle de alucinação dentro do ciclo
O crítico é um modelo com capacidade de visão executado dentro do ciclo de produção, e não um filtro aplicado depois. Cada cena é avaliada em relação ao grafo tipado de ativos segundo critérios explícitos — fidelidade do produto, alucinação de objetos, qualidade do texto, violações físicas, anatomia, qualidade geral — e as falhas voltam com um veredicto estruturado (qual dimensão, em que medida, em qual quadro) para serem regeneradas com esse feedback incorporado. Os critérios e limites são regras legíveis por humanos que a equipe pode tornar mais rigorosas, e não pesos de modelo opacos — uma escolha de design defendida em trabalhos recentes sobre sistemas de agentes, como o harness como alvo de otimização (Lee, Khattab, Finn et al.) e ciclos de crítica e revisão sobre políticas explícitas (Weng). O crítico roda em uma stack de visão própria, especializada nos modos de falha de anúncios — desvio da marca, rótulos de produto mal renderizados, CTAs embaralhados, quebras de continuidade entre cortes. O resultado no benchmark é a menor pontuação de alucinação por quadro do campo: Creatify Agent Pro com 1.90 (a única pontuação abaixo de 2.0) e Lite com 2.85, ambos abaixo do limite de reprovação de qualidade de produção, 3.0; todas as bases T2V puras pontuam 3.65–3.85, e a HeyGen V3, 4.40.
3 Benchmark
Os benchmarks de qualidade de vídeo existentes (VBench, VBench-2.0, rankings pareados de video arena) medem a fidelidade quadro a quadro em modelos de texto para vídeo puros; nenhum mede se o resultado funciona como anúncio nos eixos que determinam se ele pode ser publicado — força do gancho, fidelidade à marca, clareza do CTA, eficácia do anúncio, custo das alucinações, acabamento de produção. O VideoAdAgent Bench v1 foi criado para preencher essa lacuna; o ranking completo, os artefatos de avaliação e os scripts para reexecução estão disponíveis publicamente na página do benchmark.
3.1 Conjunto de briefings
O benchmark cobre todos os principais padrões de anúncios de performance — problema-solução, antes-depois, demonstração de produto, depoimento, lifestyle —, além de testes de estresse voltados aos eixos mais difíceis da produção com múltiplas cenas (storytelling com âncora, consistência de persona, reutilização de ativos da marca, texto de CTA estruturado, conformidade com o arco de persuasão). Cada briefing é um objeto estruturado (produto, intenção, formato, restrições, materiais de entrada) que usa marcas fictícias e mockups de produto gerados por IA para evitar propriedade intelectual e dados pessoais de clientes reais. O conjunto completo é pré-registrado em um commit com tag antes que qualquer sistema gere saídas, para que nenhum sistema possa ser ajustado aos briefings específicos.
3.2 Protocolo de avaliação
O benchmark separa três questões independentes em três eixos de avaliação pareada independentes. Cada par é avaliado por dois juízes LLM com capacidade de visão (Claude Opus 4.7 + GPT-5), duas vezes, com as posições trocadas para controlar o viés de esquerda vs. direita; um veredicto só conta quando o juiz concorda consigo mesmo após a troca, e os dois juízes precisam concordar para haver um veredicto de consenso.
| Eixo | Pergunta | Pares | Métrica principal |
|---|---|---|---|
| Eixo 1 — Capacidade | O agente é melhor que outros sistemas agênticos de vídeo? | Creatify contra todos os agentes de vídeo de uso geral (HeyGen V3, Luma). Os juízes veem o briefing. | Taxa de vitória contra o campo agêntico. |
| Eixo 2 — Qualidade do Anúncio | O agente é melhor que os modelos T2V puros mais fortes? | Creatify contra Veo 3.1, Kling 3.0, Seedance 2.0. Duas configurações de base por modelo: cena única (chamada de API padrão — um prompt, um clipe de 8–12 s) e múltiplas cenas (prompts planejados por cena, unidos). Os juízes veem o briefing e pontuam oito dimensões de qualidade do anúncio; a tabela principal mostra a configuração de múltiplas cenas. | Preferência geral (0–1). |
| Eixo 3 — Qualidade de Produção do Vídeo | O resultado é uma entrega de maior qualidade, independentemente do briefing? | Os mesmos pares do Eixo 2, mas os juízes não veem o briefing. Critérios de alucinação por quadro são incorporados com peso 3× em relação à conformidade estrutural. | Pontuação de qualidade de vídeo (0–1). |
A pontuação composta mostrada no ranking combina o Eixo 2 (qualidade do anúncio) e o Eixo 3 (qualidade de produção), então um sistema precisa ter bom desempenho nos dois eixos para subir. Uma pontuação de alucinação por quadro (0–10, quanto menor, melhor; ≥ 3.0 é reprovação em qualidade de produção) é incorporada ao Eixo 3 e publicada como uma coluna separada no ranking.
4 Resultados
A pontuação composta coloca o Creatify Agent em primeiro lugar no campo; as duas variantes em produção superam todos os agentes de vídeo de uso geral e todas as bases T2V puras em todas as métricas agregadas. Todos os sistemas — a Creatify e todos os concorrentes — são avaliados em condições de tentativa única: um briefing entra, um anúncio sai, sem rodada de feedback. Em produção, o Creatify Agent é conversacional e permite revisões cirúrgicas por cena; o benchmark remove essa capacidade de propósito para manter a comparação justa com modelos de tentativa única, o que significa que a experiência em produção supera os números apresentados aqui.
| Posição | Sistema | Composta | Eixo 1 | Eixo 2 | Eixo 3 | Alucinação ↓ |
|---|---|---|---|---|---|---|
| 1 | Creatify Agent · Pro | 0.901 | 0.732 | 0.775 | 0.855 | 1.90 |
| 2 | Creatify Agent · Lite | 0.836 | 0.716 | 0.757 | 0.778 | 2.85 |
| 3 | Luma Agent | 0.585 | 0.580 | 0.603 | 0.741 | 3.20 |
| 4 | HeyGen V3 Agent | 0.327 | 0.358 | 0.378 | 0.609 | 4.40 |
| 5 | Seedance 2.0 (múltiplas cenas) | 0.312 | — | 0.337 | 0.588 | 3.65 |
| 6 | Kling 3.0 (múltiplas cenas) | 0.301 | — | 0.365 | 0.585 | 3.80 |
| 7 | Veo 3.1 (múltiplas cenas) | 0.287 | — | 0.362 | 0.549 | 3.85 |
5 Estudos de caso
Três resultados reais do app em produção, gerados a partir do mesmo prompt e comparados com as alternativas comerciais mais fortes (um modelo T2V fundacional e um agente de vídeo de uso geral). Não foram selecionados para o relatório. Cada caso mostra uma capacidade diferente do agente — decomposição do briefing, embasamento em ativos da marca, pesquisa na web — sem equivalente em tentativa única.
5.1 Anúncio de culinária com várias tomadas
Anúncio de culinária de 20 segundos para o TikTok, com ~50 cortes de ~0.4s cada. Comparado com o Veo 3.1 (T2V de tomada única) e a HeyGen V3 (agente de vídeo de uso geral).
Prompt"make a super fast paced, .4 second multi shot cooking video making chicken pesto pasta. full video is 20 seconds"
O produtor interpreta o prompt como uma lista de tomadas, decompõe em ~50 cortes enviados em paralelo a diretores por cena e sincroniza o áudio ao ritmo dos cortes. A API do Veo 3.1 não tem parâmetro para duração total nem para estrutura com várias tomadas (duração máxima por chamada de 8 s, saída de uma tomada). A HeyGen V3 interpreta o prompt como conteúdo de narração para o seu avatar, e não como especificação de tomadas.
5.2 Anúncio para Instagram ancorado em imagem da marca
O usuário envia uma imagem de referência da marca TopStep e pede um anúncio para Instagram com um trilheiro chegando ao cume. Comparado com o Veo 3.1 de imagem para vídeo (imagem da marca como quadro inicial) e a HeyGen V3 (apenas prompt — sem entrada de imagem).
Prompt"Create an Instagram carousel ad set for TopStep @input:image-1 using the reference image and inserting a hiker making his way up to mountain with the goal of getting to the top of the mountain"
A imagem de referência entra no grafo tipado de ativos e ancora todas as cenas: as cores da marca se mantêm, a marca é renderizada como uma camada de tipografia verificada na cartela final e o personagem do trilheiro se mantém ao longo do arco preparação→esforço→cume. O Veo 3.1 preserva o quadro inicial dentro de uma única tomada de 8 segundos, mas não tem representação de um arco com várias cenas. A API da HeyGen V3 aceita apenas um texto de prompt, então a imagem da marca não é usada.
5.3 Briefing só com URL, sem ativos enviados
O usuário cola uma URL; o agente acessa o site, extrai a identidade da marca e escreve o próprio briefing. Nenhuma das bases consegue acessar a web.
Prompt"Create a vertical TikTok video ad for https://omakai.com/"
O OMAKAI é um restaurante de sushi omakase em Miami. A etapa de busca na web do produtor acessa omakai.com, extrai o nome da marca, o conceito omakase e o posicionamento em Miami e, então, embasa o storyboard antes de qualquer chamada de geração. Nenhuma das bases tem busca na web: o Veo 3.1 produz imagens de restaurante visualmente competentes, mas genéricas no tema, a partir do texto do prompt; a HeyGen V3 lê a própria URL como fala da locução. Briefings só com URL são o caso predominante no onboarding de pequenas e médias empresas no app em produção.
6 Limitações
A alucinação é baixa, mas não zero. As duas variantes da Creatify ficam abaixo do limite de alucinação de qualidade de produção (Pro com 1.90, Lite com 2.85), mas uma pequena parcela dos anúncios gerados pelo Pro ainda apresenta uma leve oscilação no texto da marca ou uma inconsistência sutil entre cortes que o crítico deixou passar. Reduzir esse resíduo a zero é uma linha de pesquisa ativa.
Apenas avaliação de tentativa única. O benchmark avalia um briefing de entrada e um anúncio de saída, sem rodada de feedback. O agente em produção é conversacional; quando o usuário aponta um defeito residual ("o preço na cena 3 está errado"), ele dispara uma regeneração cirúrgica daquela cena com a correção incorporada. A taxa de alucinação alcançável com feedback interativo é significativamente menor que o número de tentativa única apresentado aqui e não é estudada neste relatório.
7 Reprodutibilidade
Todas as afirmações deste relatório podem ser reproduzidas a partir do benchmark público, lançado como open source junto com este anúncio em github.com/creatify-ai/VABench. O conjunto de briefings, os schemas, os prompts dos juízes, os critérios de pontuação, as estruturas de execução e os scripts de agregação estão todos incluídos. O conjunto de briefings foi pré-registrado em um commit com tag antes que qualquer sistema gerasse saídas, para que nenhum sistema do benchmark pudesse ter sido ajustado aos briefings específicos.
8 Trabalhos relacionados
- Geração de vídeo multiagente: Mora, VideoDirectorGPT, FilmAgent, StoryAgent, VISTA.
- Benchmarks de qualidade de vídeo: VBench / VBench-2.0; VideoGen-Eval; Artificial Analysis Video Arena, para controle do viés de posição em comparações pareadas.
- Modelagem de recompensa para vídeo: VideoReward / Flow-DPO, UnifiedReward.
- Critérios específicos para anúncios: Springboards Creativity Benchmark, AdsQA, o Pitt Ads Dataset, "Decoding the Hook" para avaliação dos 3 primeiros segundos.
- Garantia de qualidade em ciclo fechado: Meta-Harness (Lee, Khattab, Finn et al.); Learning Beyond Gradients (Weng), sobre ciclos de crítica e revisão sobre políticas explícitas.